1번
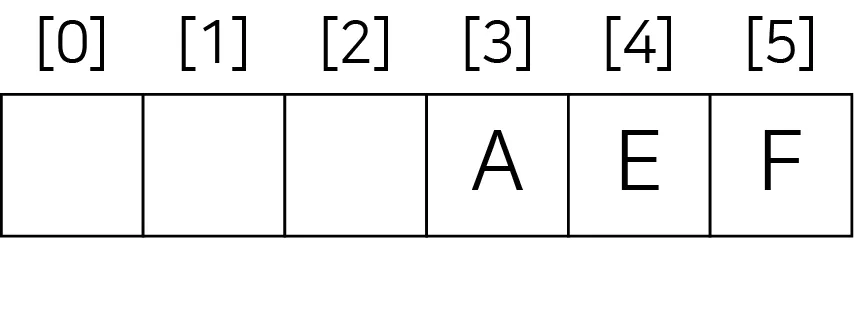
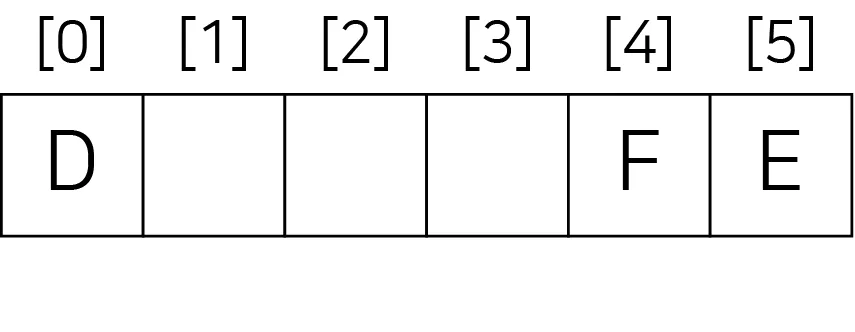
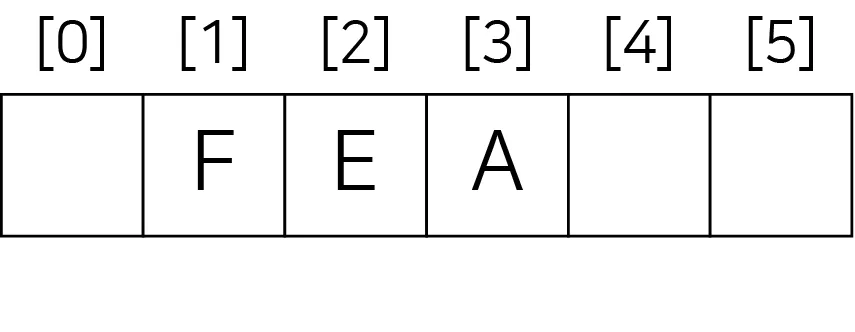
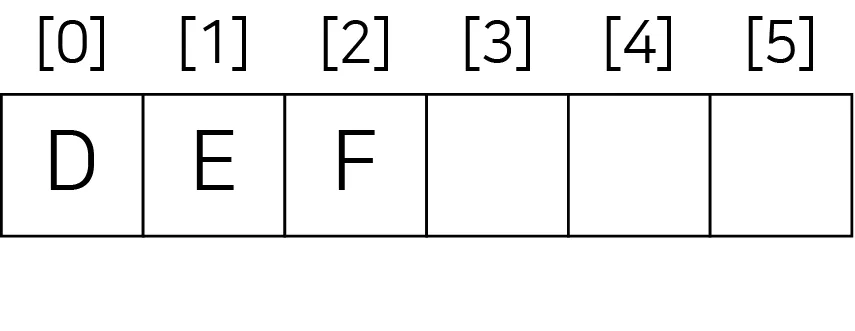
다음 원형 큐에 대해 1부터 7까지 연산을 차례로 수행했을 때, 수행이 완료된 후 큐의 상태는? (단, 현재 상태는 front = 2, rear = 3이다)

- ①
- ②
- ③
- ④
2번
다음 C 코드를 사용하여 배열을 선언하였고 arr[0][0][0]의 주소를 α라고 할 때, arr[3][4][2]의 행 우선 순서 주소는?
- ①
α + 34
- ②
α + 78
- ③
α + 96
- ④
α + 112
3번
다음 C 언어로 작성된 함수들의 시간 복잡도에 대한 설명으로 옳은 것은?
- ①
func1 함수는 이중 for 반복문으로 구성되어 시간 복잡도는 O()이다.
- ②
func2 함수는 for 반복문으로 구성되어 시간 복잡도는 O()이다.
- ③
func3 함수는 for 반복문이 없어 시간 복잡도는 O()이다.
- ④
(가) 문장을 func2(n/2);으로 수정할 경우, func3 함수의 시간 복잡도는 O()이다.
4번
다음 C 프로그램의 실행 결과는?
- ①
31
- ②
46
- ③
62
- ④
511
5번
인접 행렬로 표현된 방향 그래프 중 위상 정렬이 불가능한 것은?
- ①
- ②
- ③
- ④
6번
다음 C 코드에서 power(2.0, 20, 0)를 호출할 때, 변수 c의 마지막 출력값은?
- ①
5
- ②
6
- ③
7
- ④
8
7번
다음 그래프에 대해 위상 정렬(topological sort)을 수행할 때 생성되는 위상 순서로 옳지 않은 것은?
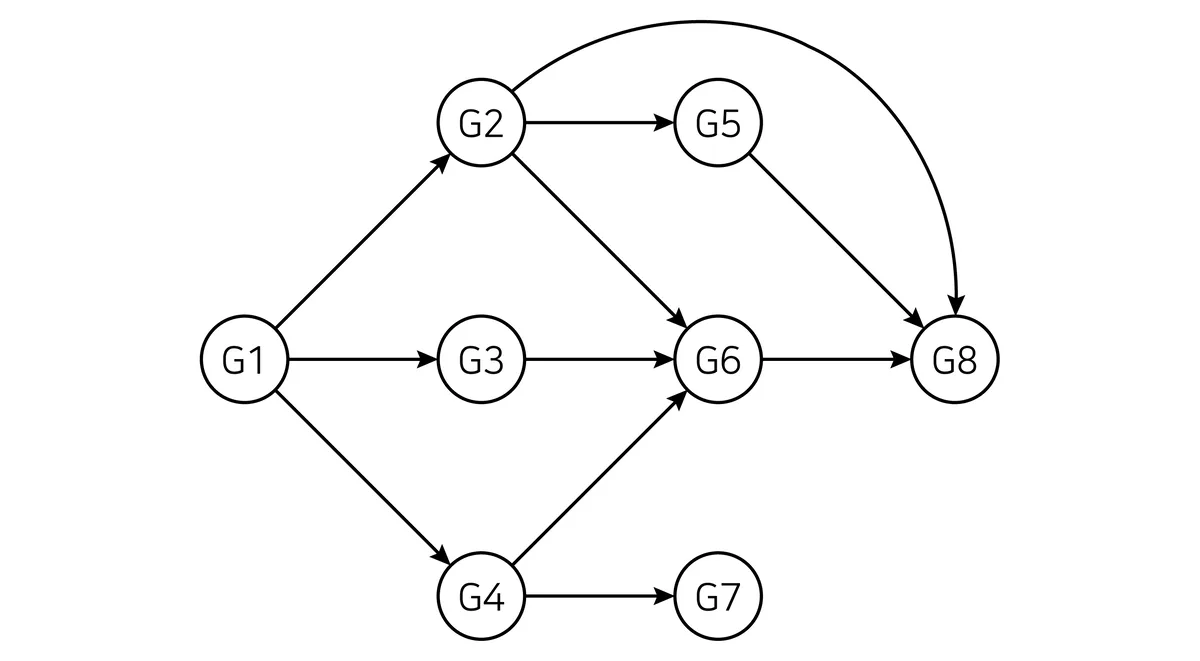
- ①
G1, G2, G3, G4, G5, G6, G7, G8
- ②
G1, G2, G3, G4, G5, G8, G6, G7
- ③
G1, G3, G2, G4, G6, G5, G8, G7
- ④
G1, G4, G3, G2, G7, G6, G5, G8
8번
다음은 연결 리스트를 이용하여 스택을 구현한 C 코드이다. (가), (나)에 들어갈 내용을 바르게 연결한 것은?
(가) (나)
- ①t->next = head;head->next = t->next;
- ②t->next = head->next;head->next = t->next;
- ③t->next = head->next;head = t->next;
- ④t->next = head->next;head->next = t;
9번
다음은 후위 표기식을 스택을 이용하여 사칙연산을 하는 알고리즘을 구현한 C 프로그램이다. 출력 결과가 12인 프로그램의 실행에 대한 설명으로 옳은 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄷ
- ③
ㄴ, ㄹ
- ④
ㄱ, ㄴ, ㄹ
10번
선형 조사법(linear probing)을 사용하는 해시 테이블에서 버킷(bucket)을 삭제할 때, 빈 버킷(empty bucket)으로 비워 두지 않고 삭제했음을 표시하는 이유는? (단, 버킷 내 슬롯(slot) 수는 1이다)
- ①
1차 군집 현상이 발생하지 않게 한다.
- ②
해시 테이블의 전체 크기를 자동으로 기존 크기의 두 배로 확장시킨다.
- ③
충돌로 인해 원래 해시 주소와는 다른 주소에 저장된 레코드에 대한 탐색이 가능하게 한다.
- ④
해시 테이블에 저장된 모든 레코드의 키값이 항상 오름차순으로 정렬된 상태가 되도록 유지시킨다.
11번
다음과 같이 6개의 키값으로 구성된 4개의 입력 배열 데이터 (가) ~ (라)를 각각 순서대로 삽입하여 4개의 AVL 트리를 생성하였다. 생성된 모든 트리에 공통으로 존재하는 리프 노드 키값으로 옳은 것은?
- ①
2
- ②
4
- ③
5
- ④
9
12번
다음 C 프로그램의 실행 결과는?
- ①
14
- ②
15
- ③
16
- ④
17
13번
2차원 배열 A[1:15][1:20]의 원소 A[10][8]에 대하여, 행 우선 순서 주소와 열 우선 순서 주소를 바르게 연결한 것은? (단, 첫 번째 원소 A[1][1]의 주소는 2000이고, 각 원소의 크기는 1바이트이다)
행 우선 순서 주소 열 우선 순서 주소
- ①21142265
- ②21822187
- ③21872114
- ④22652182
14번
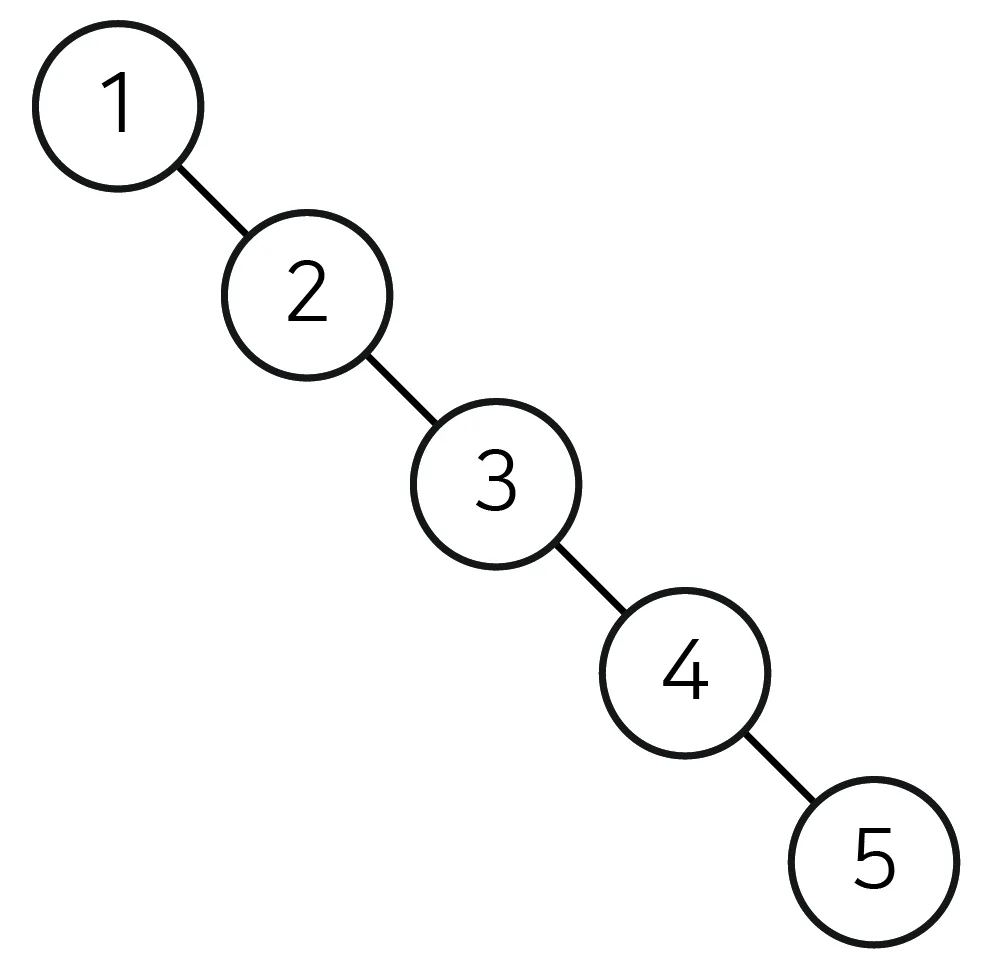
이진 트리(binary tree) 중에서 전위 순회(preorder traversal)와 중위 순회(inorder traversal)한 결과가 동일한 것은?
- ①
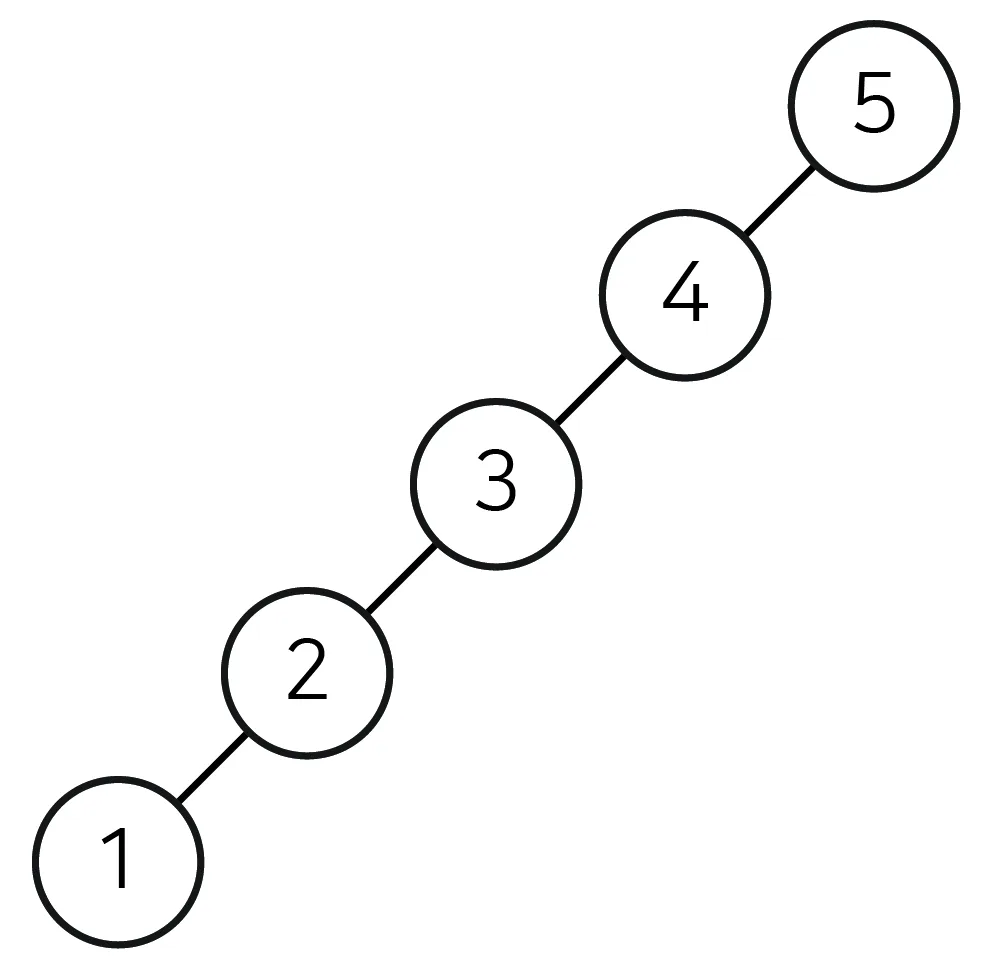
- ②
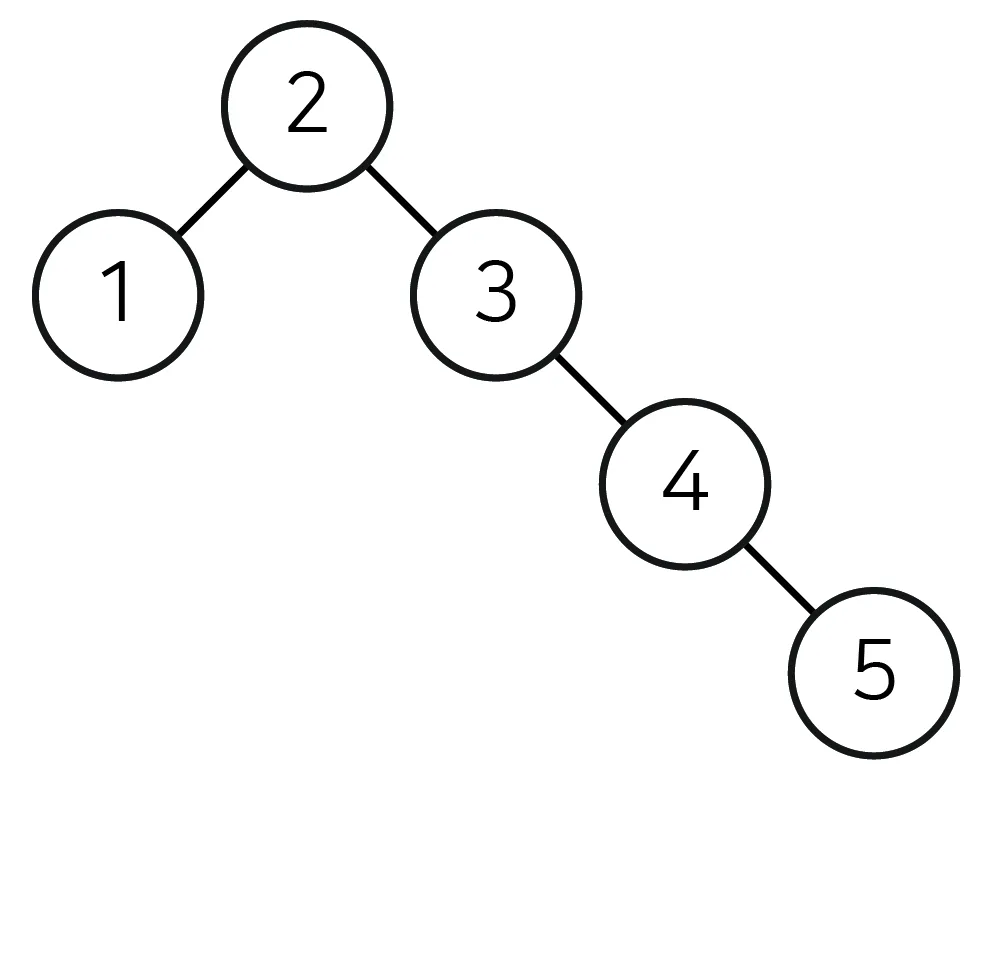
- ③
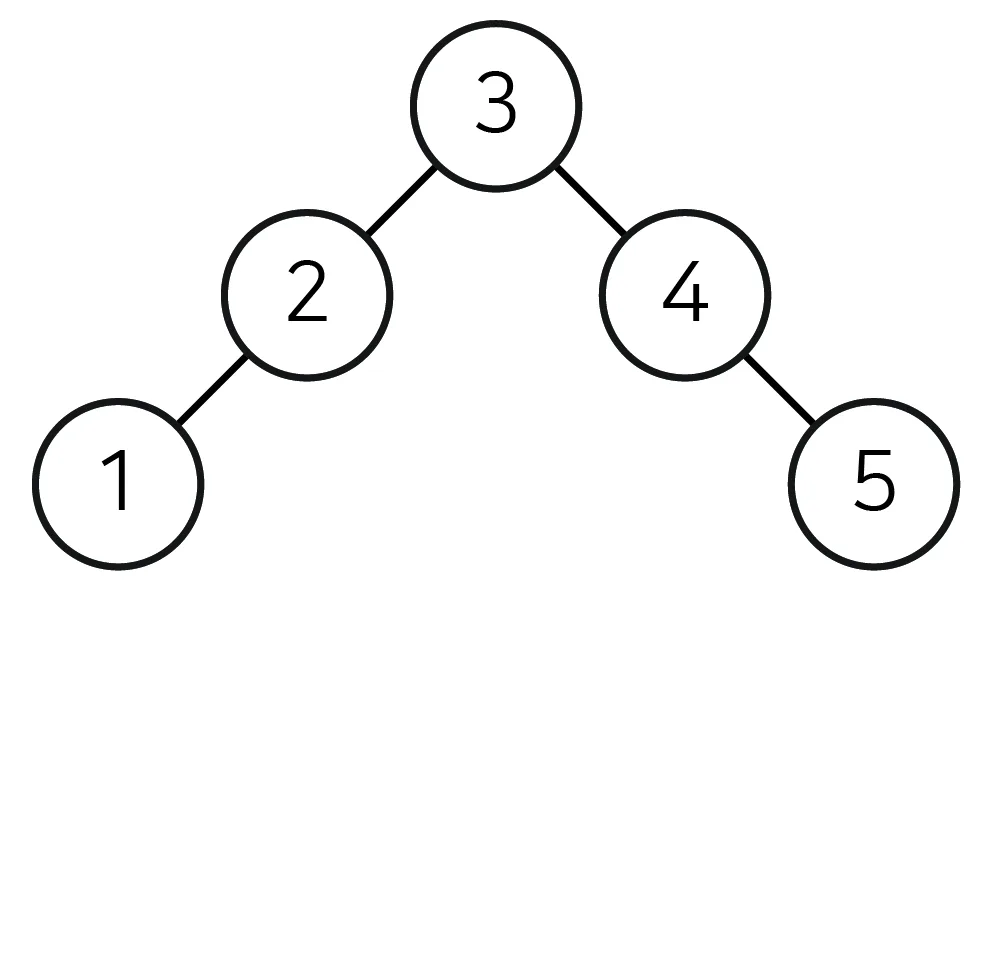
- ④
15번
다음 C 언어로 구현한 arraySort 함수에서 재귀 호출 횟수의 최댓값이 가장 큰 배열 arr의 입력내용은? (단, arraySort 함수의 최초 호출 시 low 변수와 high 변수는 배열 arr의 첫 번째와 마지막 데이터의 인덱스이다)
- ①
1, 2, 3, 4, 5, 6, 7, 8, 9, 10
- ②
2, 4, 6, 8, 10, 5, 3, 7, 1, 9
- ③
3, 6, 2, 8, 5, 10, 7, 1, 9, 4
- ④
10, 9, 8, 7, 6, 5, 4, 3, 2, 1
16번
다음 C 코드로 표현한 알고리즘의 시간 복잡도는?
- ①
- ②
- ③
- ④
17번
정점의 개수가 n인 단순 그래프가 트리이기 위한 필요충분조건으로 옳지 않은 것은? (단, n은 3 이상의 정수이다)
- ①
사이클이 없고 연결요소의 개수가 1이다.
- ②
임의의 두 정점 사이에 존재하는 경로의 개수는 1이다.
- ③
간선의 개수가 n-1이고, 차수가 1인 정점의 개수가 2 이상이다.
- ④
사이클이 없지만, 인접하지 않은 임의의 두 정점 사이에 간선을 추가하면 사이클의 개수가 1이 된다.
18번
55개 간선(edge)을 갖는 무방향 완전 그래프의 정점(vertex) 개수는?
- ①
8
- ②
9
- ③
10
- ④
11
19번
다음 8개의 데이터를 순서대로 삽입하여 AVL 트리를 구성하였을 때, 이에 대한 설명으로 옳은 것은?
- ①
루트 노드의 번호는 17이다.
- ②
중위 순회했을 때 네 번째 방문하는 노드의 번호는 15이다.
- ③
전위 순회했을 때 세 번째 방문하는 노드의 번호는 10이다.
- ④
후위 순회했을 때 다섯 번째 방문하는 노드의 번호는 32이다.
20번
다음 조건에서 데이터가 순서대로 해시 테이블에 입력된다고 할 때, 원래 계산된 버킷(bucket)에 저장되지 않는 데이터의 개수는? (단, 충돌(collision)로 인한 오버플로 발생 시, 선형 조사법(linear probing)으로 처리한다)
- ①
1
- ②
2
- ③
3
- ④
4
21번
「클라우드컴퓨팅 발전 및 이용자 보호에 관한 법률 시행령」에 따른 클라우드컴퓨팅서비스의 보안인증 절차 등에 대한 설명으로 옳지 않은 것은?
- ①
한국인터넷진흥원은 클라우드컴퓨팅서비스에 대한 보안인증 기관의 하나이다.
- ②
국가기관 등이 이용하는 클라우드컴퓨팅서비스의 보안인증 기준은 국가정보원장이 정한다.
- ③
보안인증의 유효기간은 5년이다.
- ④
보안인증의 유효기간은 연장할 수 있다.
22번
기업망을 보호하기 위해 네트워크 경계를 신뢰 판단의 전제로 삼지 않고, 위치와 관계없이 모든 접근을 지속적으로 검증하고, 최소 권한만 부여하는 보안 방식은?
- ①
다중 인증(Multi-factor Authentication)
- ②
챌린지 핸드셰이크 인증 프로토콜(Challenge Handshake Authentication Protocol)
- ③
제로 트러스트 보안 모델(Zero Trust Security Model)
- ④
임의적 접근 통제 모델(Discretionary Access Control Model)
23번
IPSec ESP(Encapsulating Security Payload)의 패킷 포맷에 대한 설명으로 옳지 않은 것은?
- ①
32비트의 보안 매개변수 색인(security parameter index) 필드에는 같은 보안연관(security association)에 속하는 각 패킷에 대해 서로 다른 보안 매개변수 색인값이 주어진다.
- ②
32비트의 순서 번호(sequence number) 필드에는 데이터그램의 순서를 나타내는 카운터 값이 저장된다.
- ③
8비트의 다음 헤더(next header) 필드는 IP 데이터그램에 의해 전달되는 페이로드의 데이터 유형을 나타낸다.
- ④
ICV(Integrity Check Value) 필드에는 IP 헤더와 ICV를 제외한 전체 패킷에 대해 계산한 인증 데이터가 저장된다.
24번
인증 프로토콜에 대한 설명으로 옳지 않은 것은?
- ①
S/Key 인증은 해시함수 체인을 사용한다.
- ②
공개키 암호를 이용한 인증에서는 상대방의 공개키를 알고 있어야 한다.
- ③
영지식 증명(zero-knowledge proof)으로 비밀정보를 노출하지 않고 비밀정보의 소유를 증명할 수 있다.
- ④
커버로스(Kerberos)에서 티켓발급 서버(TGS)는 서비스 서버의 접속에 필요한 티켓을 사용자의 공개키로 암호화하여 전달한다.
25번
CA(Certification Authority)가 사용자 A에게 발급한 X.509 버전 3 형식의 인증서에 포함되는 정보가 아닌 것은?
- ①
A의 공개키
- ②
A의 개인키
- ③
인증서의 유효 기간
- ④
CA가 사용한 서명 알고리즘
26번
DNS 스푸핑 공격에 대한 설명으로 옳지 않은 것은?
- ①
사용자가 악의적인 웹 사이트에 접속하도록 하는 공격이다.
- ②
공격자는 사용자의 DNS 질의에 대해 위조된(spoofed) 응답이 사용자에게 전달되게 한다.
- ③
DNS 캐시 포이즈닝(poisoning)은 위조된 DNS 응답이 로컬 DNS 서버의 캐시에 저장되므로 일정 기간 사용자에게 피해를 줄 수 있다.
- ④
디지털 서명으로 DNS 데이터그램의 진위 여부를 확인할 수 있는 SSH(Secure Shell)가 DNS 캐시 포이즈닝 공격을 방지하기 위해 설계되었다.
27번
다음 제시문에 해당하는 위험처리 전략은?
- ①
위험감소
- ②
위험회피
- ③
위험전가
- ④
위험수용
28번
다음은 정보보호의 요구사항에 대한 설명이다. (가)에 들어갈 용어는?
- ①
기밀성
- ②
인증성
- ③
무결성
- ④
가용성
29번
CC 인증은 시스템에 대한 보안을 평가하기 위하여 EAL(Evaluation Assurance Level)의 1 ~ 7단계를 두어 평가한다. ‘정형화된 설계 검증 및 시험’ 단계에 해당하는 것은?
- ①
EAL4
- ②
EAL5
- ③
EAL6
- ④
EAL7
30번
리눅스 /etc/group 파일의 4개 필드에 대한 설명으로 옳지 않은 것은?
- ①
첫 번째 필드는 그룹의 이름을 나타낸다. groupadd 명령을 이용하여 새로운 그룹을 생성할 수 있다.
- ②
두 번째 필드는 그룹 패스워드를 나타내는 부분이지만 /etc/gshadow 파일에서 별도 관리하는 경우에는 ‘x’로만 표기된다.
- ③
세 번째 필드는 리눅스에서 그룹에 부여한 번호로 그룹 생성 이후에는 변경할 수 없다.
- ④
네 번째 필드에 해당 그룹에 속한 사용자의 로그인 ID가 기록된다.
31번
리눅스의 find 명령에 대한 설명으로 옳지 않은 것은?
- ①
명령: find / -name '*.c'
설명: 확장자가 c인 파일을 모두 찾는다.
- ②
명령: find / -mtime -2
설명: 최근 48시간 이내에 마지막으로 수정된 파일을 모두 찾는다.
- ③
명령: find / -user user1
설명: 소유자가 user1인 파일을 모두 찾는다.
- ④
명령: find / -type 4755
설명: 권한 설정이 4755로 설정된 파일을 모두 찾는다.
32번
AES에 대한 설명으로 옳지 않은 것은?
- ①
SPN 구조를 사용한다.
- ②
128비트 블록 단위로 암호화한다.
- ③
암호화 함수와 복호화 함수가 동일하다.
- ④
키 길이에 따라 10, 12, 14 라운드로 구성된다.
33번
정보보안 목표와 그 목표에 대한 위협 요소를 바르게 연결한 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄷ
- ③
ㄴ, ㄷ
- ④
ㄱ, ㄴ, ㄷ
34번
암호에 대한 설명으로 옳지 않은 것은?
- ①
공개키 암호 알고리즘은 트랩도어 단방향 함수에 기반을 둔다.
- ②
대칭키 암호 알고리즘은 공개키 암호 시스템에 비해서 암호화 및 복호화 속도가 빠르다.
- ③
공개키 암호 알고리즘의 대표적인 알고리즘은 DES이다.
- ④
공개키 암호는 전자서명에 사용된다.
35번
SSL(Secure Socket Layer)에 대한 설명으로 옳지 않은 것은?
- ①
TCP/IP 4계층 모델의 네트워크 계층에서 동작하는 프로토콜이다.
- ②
암호화된 웹 서핑을 가능하게 한다.
- ③
서버 인증, 클라이언트 인증, 암호화 세션 기능을 제공한다.
- ④
SSL을 지원하는 웹 사이트 URL은 ‘https://’로 시작한다.
36번
「개인정보 보호법」상 고정형 영상정보처리기기의 설치ㆍ운영 제한에 대한 설명으로 옳지 않은 것은?
- ①
교통단속을 위하여 정당한 권한을 가진 경우 공개된 장소에 고정형 영상정보처리기기를 설치ㆍ운영할 수 있다.
- ②
누구든지 불특정 다수가 이용하는 목욕실, 화장실, 발한실, 탈의실 등 개인의 사생활을 현저히 침해할 우려가 있는 장소의 내부를 볼 수 있도록 고정형 영상정보처리기기를 설치ㆍ운영하여서는 아니 된다. 다만 대통령령으로 정하는 시설에 대하여는 그러지 아니하다.
- ③
고정형영상정보처리기기운영자는 고정형 영상정보처리기기의 설치 목적과 다른 목적으로 고정형 영상정보처리기기를 임의로 조작하거나 다른 곳을 비춰서는 아니 되나, 녹음기능은 사용할 수 있다.
- ④
고정형영상정보처리기기운영자는 대통령령으로 정하는 바에 따라 고정형 영상정보처리기기 운영ㆍ관리 방침을 마련하여야 한다. 다만 「개인정보 보호법」에 따라 개인정보 처리방침을 정할 때 고정형 영상정보처리기기 운영ㆍ관리에 관한 사항을 포함시킨 경우에는 고정형 영상정보처리기기 운영ㆍ관리 방침을 마련하지 아니할 수 있다.
37번
검증필 암호모듈(KCMVP)의 검증대상 암호알고리즘이 아닌 것은?
- ①
ARIA
- ②
RC5
- ③
AES
- ④
LEA
38번
포트 스캔(Port Scan)에 대한 설명으로 옳지 않은 것은?
- ①
공격 대상 시스템의 운영체제 확인이 가능하다.
- ②
특정 패킷을 보내서 공격 대상 시스템의 어떤 서비스 포트가 열려 있고 닫혀 있는지 확인할 수 있다.
- ③
스캐닝 공격 기법 종류에는 TCP Scan, UDP Scan, Fin Scan, XMAS Scan 등이 있다.
- ④
UDP Scanning은 3-Way Handshaking의 특징을 악용하는 방법이다.
39번
다음 설명의 (가), (나), (다)에 들어갈 용어를 바르게 연결한 것은?
(가) (나) (다)
- ①NAC방화벽IPS
- ②IPSDRM방화벽
- ③NACIPSIDS
- ④DRMIDSNAC
40번
암호 알고리즘에 대한 설명으로 옳은 것은?
- ①
AES는 다에먼(Daemen)과 레이먼(Rijmen)이 제안한 Rijndael을 기반으로 제정된 미국 표준 알고리즘이다.
- ②
SEED는 미국 NIST가 표준으로 선정한 대칭키 알고리즘이다.
- ③
ARIA는 스트림 암호 방식으로 동작하는 알고리즘이다.
- ④
IDEA는 리베스트(Rivest)가 개발한 알고리즘으로 블록, 키, 라운드 크기가 모두 가변적이다.
41번
‘주문’, ‘제품1’, ‘제품2’ 테이블에 대하여 ‘주문 ÷ 제품1’, ‘주문 ÷ 제품2’의 연산 결과로 옳은 것은?
주문 | 제품1 | 제품2 | |||||
주문고객 | 제품이름 | 제조업체 | 제품이름 | 제조업체 | 제품이름 | ||
C1 | 라면 | P1 | 음료 | P1 | 라면 | ||
C2 | 과자 | P2 | 음료 | ||||
C3 | 음료 | P1 | |||||
C1 | 음료 | P1 | |||||
C2 | 음료 | P1 | |||||
주문 ÷ 제품1 주문 ÷ 제품2
- ①
주문고객
주문고객
제조업체
C3
C1
P1
C1
C2
- ②
주문고객
주문고객
제조업체
C1
C2
P2
C2
- ③
주문고객
제품이름
제조업체
주문고객
제품이름
제조업체
C3
음료
P1
C1
라면
P1
C1
음료
P1
C1
음료
P1
C2
음료
P1
- ④
주문고객
제품이름
제조업체
주문고객
제품이름
제조업체
C1
라면
P1
C2
과자
P2
C2
과자
P2
42번
분산 데이터베이스 시스템에 대한 설명으로 옳은 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄹ
- ③
ㄴ, ㄷ
- ④
ㄷ, ㄹ
43번
빅데이터 분석 및 처리를 위한 기술인 하둡(Hadoop)에 대한 설명으로 옳은 것은?
- ①
맵리듀스(MapReduce) 기법을 사용하는 파일 시스템은 병렬 처리를 지원하지 않는다.
- ②
맵리듀스 기법에서 reduce() 함수의 입력 키 타입은 map() 함수의 출력 키 타입과 다르다.
- ③
맵리듀스 기법의 map() 함수는 각 입력 레코드에 대해 출력이 없거나, 한 개 이상의 (키, 값) 쌍들을 출력한다.
- ④
하둡 분산 파일 시스템(HDFS)에서 각 파일의 블록을 식별하기 위한 메타데이터를 저장하는 서버는 데이터노드(DataNode)이다.
44번
다음 ‘고객’ 테이블과 ‘주문’ 테이블에서 아래에 주어진 SQL문과 동일한 결과를 출력하는 SQL문은? (단, 밑줄 속성은 기본키이며, ‘주문’ 테이블의 고객번호는 ‘고객’ 테이블의 번호를 참조하는 외래키이다)
고객 | ||
번호 | 이름 | 성별 |
1001 | 김홍도 | M |
1002 | 허균 | M |
1003 | 유관순 | F |
주문 | ||
고객번호 | 제품번호 | 개수 |
1001 | AA | 1 |
1003 | AA | 1 |
1001 | BA | 2 |
- ①
SELECT 이름, 제품번호, 개수
FROM 고객 OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ②
SELECT 이름, 제품번호, 개수
FROM 고객 RIGHT OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ③
SELECT 이름, 제품번호, 개수
FROM 고객 LEFT OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ④
SELECT 이름, 제품번호, 개수
FROM 고객, 주문
WHERE 번호 IN (SELECT 고객번호 FROM 주문)
ORDER BY 이름, 제품번호;
45번
기본키가 EMP_ID인 두 테이블 EMP1(EMP_ID, NAME, SALARY), EMP2(EMP_ID, ADDRESS)에 대하여 사용자 A1이 다음 순서대로 모두 수행하고 ‘순서 5’의 실행 결과가 다음과 같을 때, 옳은 설명은? (단, EMP_ID, NAME, SALARY의 데이터 타입은 각각 정수형, 문자열, 정수형이다)
순서 | A1이 수행한 SQL 문 | ||
1 | CREATE VIEW EMP_VIEW1 AS SELECT * FROM EMP1 WHERE SALARY>1000 WITH CHECK OPTION; | ||
2 | CREATE VIEW EMP_VIEW2 AS SELECT NAME, ADDRESS FROM EMP1, EMP2 WHERE EMP1.EMP_ID = EMP2.EMP_ID; | ||
3 | GRANT SELECT, INSERT ON EMP_VIEW1 TO A2; | ||
4 | GRANT SELECT, INSERT ON EMP_VIEW2 TO A2; | ||
5 | SELECT * FROM EMP_VIEW1; | ||
<순서 5의 실행 결과> | |||
EMP_ID | NAME | SALARY | |
1001 | 홍길동 | 1200 | |
1002 | 이순신 | 1500 | |
1003 | 신윤복 | 1100 | |
- ①
EMP1에 EMP_ID가 1004인 투플이 없을 때, A2는 EMP_VIEW1을 통해 EMP1에 새로운 투플 ‘(1004, “강감찬”, 1000)’을 삽입할 수 있다.
- ②
A2는 EMP_VIEW1을 통해 SALARY의 합계를 출력하는 SQL 문을 실행할 수 없다.
- ③
A2는 EMP_VIEW2에 새로운 투플을 삽입할 수 없다.
- ④
A1은 EMP_VIEW1에 대한 DELETE 권한을 A2에 부여할 수 없다.
46번
테이블을 생성하는 SQL 문에서 속성의 제약조건에 대한 설명으로 옳지 않은 것은?
- ①
CHECK는 속성이 가질 수 있는 값의 범위를 제한한다.
- ②
DEFAULT는 데이터 삽입 시 속성의 값이 명시되지 않을 때 지정된 값이 입력되도록 제한한다.
- ③
NOT NULL은 속성에 NULL이 입력되지 않도록 제한하며, FOREIGN KEY로 지정된 속성에 대해서도 지정할 수 있다.
- ④
UNIQUE는 기본키를 대체하는 속성에 부여하는 것으로, 중복되지 않고 NULL이 아닌 값이 입력되도록 제한한다.
47번
다음 SQL 문으로 오류 없이 생성된 ‘고객’과 ‘주문’ 테이블에 다음과 같이 투플이 삽입되어 있을 때 성공적으로 수행되는 SQL 문은?
고객 | 주문 | ||||||
고객번호 | 이름 | 추천고객 | 주문번호 | 고객 | 제품 | 수량 | |
C1 | 김유신 | NULL | O1 | C1 | HDD | 2 | |
C2 | 홍길동 | C1 | O2 | C1 | SSD | 1 | |
C3 | 이순신 | C2 | O3 | C4 | USB | 5 | |
C4 | 임꺽정 | C3 | |||||
C5 | 유관순 | C1 | |||||
- ①
INSERT INTO 주문 VALUES (“O4”, “C6”, “VGA”, 2);
- ②
DELETE FROM 고객 WHERE 고객번호 = “C3”;
- ③
DELETE FROM 고객 WHERE 고객번호 = “C5”;
- ④
UPDATE 고객 SET 고객번호=“C7” WHERE 고객번호=“C4”;
48번
다음 R과 S 테이블에 대해, 주어진 ‘관계대수’와 동일한 투플 결과를 출력하는 ‘SQL 문’은? (단, 밑줄로 표기된 속성은 기본키를 의미한다)
R | S | |||||
A | B | C | A | |||
a1 | 5 | c1 | a1 | |||
a2 | 10 | c2 | a1 | |||
a3 | 15 | c3 | a2 | |||
a4 | 20 | c4 | a3 |
- ①
관계대수: σ(B < 10)(R)
 R.A=S.A S
SQL 문: SELECT DISTINCT R.A, R.B, S.C, S.A
FROM R INNER JOIN S
WHERE R.B < 10;
- ②
관계대수: R
N SSQL 문: SELECT DISTINCT R.A, R.B, S.C
FROM R, S
WHERE R.A IN (SELECT S.A FROM S);
- ③
관계대수: R
 S
SQL 문: SELECT DISTINCT R.A, R.B
FROM R, S
WHERE R.A = S.A;
- ④
관계대수: R
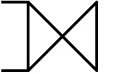 S
SQL 문: SELECT DISTINCT R.A, R.B, S.C
FROM R, S
WHERE R.A = S.A;
49번
DBMS의 3단계 스키마 구조에서 사상(mapping)과 데이터 독립성에 대한 설명으로 옳지 않은 것은?
- ①
외부/개념 사상은 외부 스키마의 데이터가 개념 스키마의 어떤 부분에 해당하는지 대응 관계를 정의한 것이다.
- ②
개념/내부 사상은 개념 스키마의 데이터가 내부 스키마를 통해 물리적 장치에 저장되는 대응 관계를 정의한 것이다.
- ③
내부 스키마가 변경되어도 개념/내부 사상을 수정하면 개념 스키마가 영향을 받지 않는다.
- ④
개념 스키마가 변경되어도 외부 스키마에 영향이 없는 성질을 물리적 데이터 독립성이라 한다.
50번
트랜잭션 , 에 대한 설명으로 옳지 않은 것은? (단, 의 초기값은 1,000이다)
시간 | |||
read(); | |||
read(); | |||
= + 500; | (가) | ||
= - 200; | |||
write(); | (나) | ||
write(); | (다) | ||
COMMIT; | (라) | ||
COMMIT; |
- ①
(가)에서 의 작업 수행 후 메모리 버퍼에 저장된 값은 1,000이다.
- ②
(나)에서 의 작업 수행 후 메모리 버퍼에 저장된 값은 1,500이다.
- ③
(다)에서 의 작업 수행 후 갱신 손실 문제가 발생한다.
- ④
(라)에서 “COMMIT”이 “ROLLBACK”으로 변경될 경우 오손 읽기 문제가 발생한다.
51번
(고객번호, 이름, 지역) 스키마로 정의된 ‘고객’ 릴레이션을 지역이 ‘서울’인 투플은 사이트 1에, 지역이 ‘부산’인 투플은 사이트 2에 분산하여 저장하는 경우에 대한 설명으로 옳은 것은? (단, 각 사이트에는 세 속성이 모두 저장된다)
- ①
투플 단위로 나누었으므로 수평 단편화이다.
- ②
‘지역’이라는 속성 단위로 나누었으므로 수직 단편화이다.
- ③
‘지역’에 따라 투플을 분산하여 저장하므로 혼합 단편화이다.
- ④
자연 조인 연산을 통해 두 사이트의 릴레이션을 원래의 릴레이션으로 복원할 수 있다.
52번
다음에서 설명하는 테이블에서 모든 회원의 이름과 추천인의 이름을 함께 출력하기 위한 SQL문은? (단, 추천인이 없는 경우 추천인의 이름은 NULL 값으로 출력한다)
- ①
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e LEFT OUTER JOIN 회원 s
ON e.추천인아이디 = s.아이디;
- ②
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e, 회원 s
WHERE e.추천인아이디 = s.아이디;
- ③
SELECT 이름, 추천인이름
FROM 회원 e
WHERE EXISTS
(SELECT 이름 AS 추천인이름 FROM 회원 WHERE e.아이디 = 추천인아이디);
- ④
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e, 회원 s
WHERE e.추천인아이디 = s.아이디
AND e.추천인아이디 IS NOT NULL;
53번
(가) ~ (다)의 빅데이터 분석 기법과 A ~ C의 설명이 바르게 연결된 것은?
(가) 군집 분석 | (나) 분류 분석 | (다) 연관 분석 |
(가) (나) (다)
- ①ABC
- ②BAC
- ③BCA
- ④CAB
54번
‘선수’ 테이블에서 검색 결과가 다음과 같이 생성되는 SQL문의 (가)에 들어갈 내용은?
선수 | ||||
선수번호 | 이름 | 포지션 | 점수 | 팀번호 |
2123 | 장영실 | CF | 30 | 2 |
3321 | 이순신 | RB | 12 | 1 |
2276 | 정약용 | LW | 6 | 1 |
1925 | 허준 | RW | 24 | 1 |
9842 | 김유신 | GK | 10 | 2 |
검색 결과 | ||||
팀번호 | 합계점수 | 최대점수 | ||
2 | 40 | 30 |
- ①
GROUP BY 팀번호;
- ②
GROUP BY 선수번호;
- ③
GROUP BY 팀번호 HAVING AVG(점수) >= 15;
- ④
GROUP BY 팀번호 HAVING MAX(점수) >= 20;
55번
데이터를 여러 디스크에 분배하여 저장하는 구조로, 데이터의 갱신이 중복해서 일어나지 않고, 가장 좋은 쓰기 성능을 갖는 RAID 레벨은?
- ①
RAID 레벨 0
- ②
RAID 레벨 2
- ③
RAID 레벨 3
- ④
RAID 레벨 6
56번
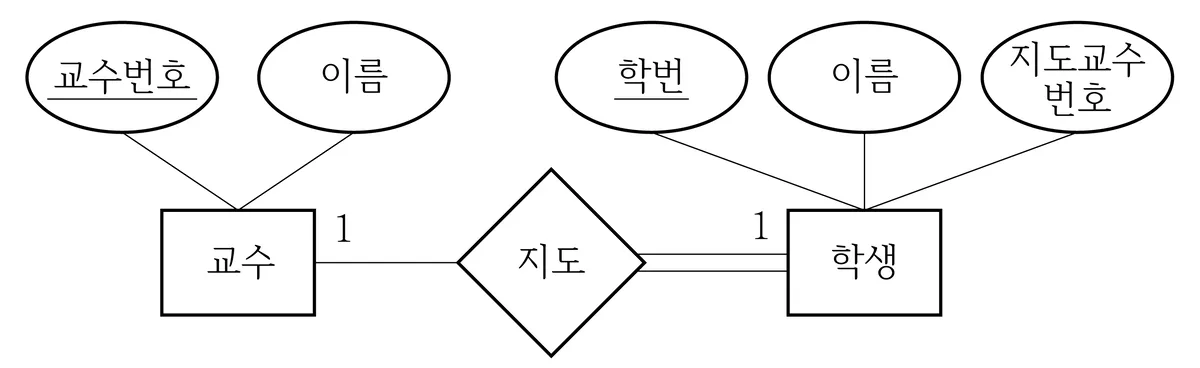
다음은 교수와 학생의 관계를 나타낸 E-R 다이어그램이다. 이를 기준으로 ‘교수’와 ‘학생’ 테이블을 생성하였을 때 옳은 것만을 모두 고르면? (단, ‘교수번호’와 ‘학번’은 기본키이고, ‘지도교수번호’는 학생의 지도교수 정보로, ‘교수번호’를 참조하는 외래키이다)
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄹ
- ③
ㄴ, ㄷ
- ④
ㄴ, ㄹ
57번
데이터베이스의 시스템 카탈로그에 저장되는 데이터로 옳지 않은 것은?
- ①
속성의 데이터 타입
- ②
테이블에 저장된 레코드 값
- ③
데이터에 대한 다양한 제약 조건
- ④
테이블 이름, 인덱스(index) 이름, 뷰(view) 이름
58번
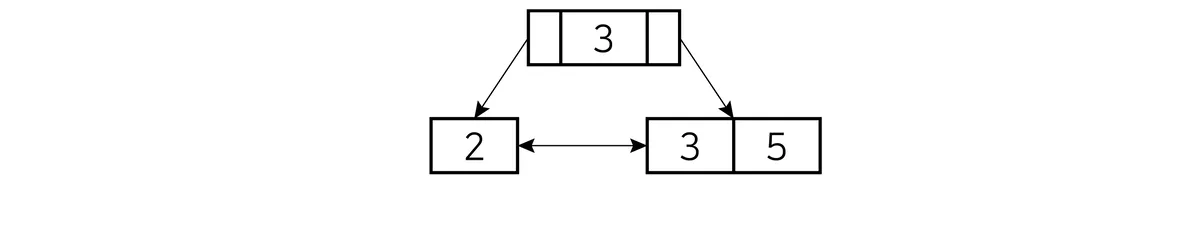
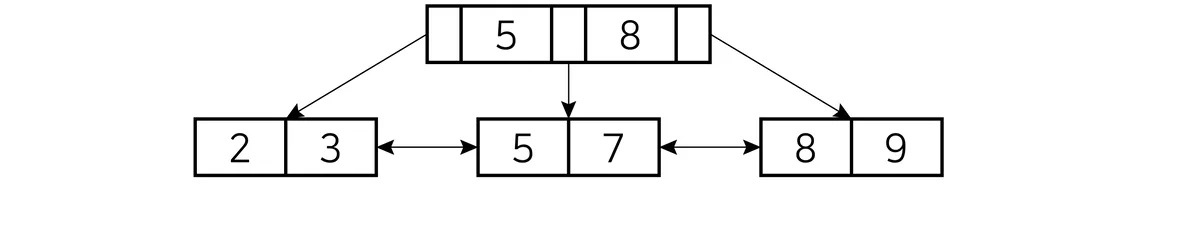
키값 2, 3, 5를 차례대로 삽입하여 다음과 같은 B+-트리가 생성되었다. 이후 9, 8, 7을 차례대로 삽입한 후 B+-트리로 옳은 것은? (단, B+-트리의 차수는 3이다)
- ①
- ②
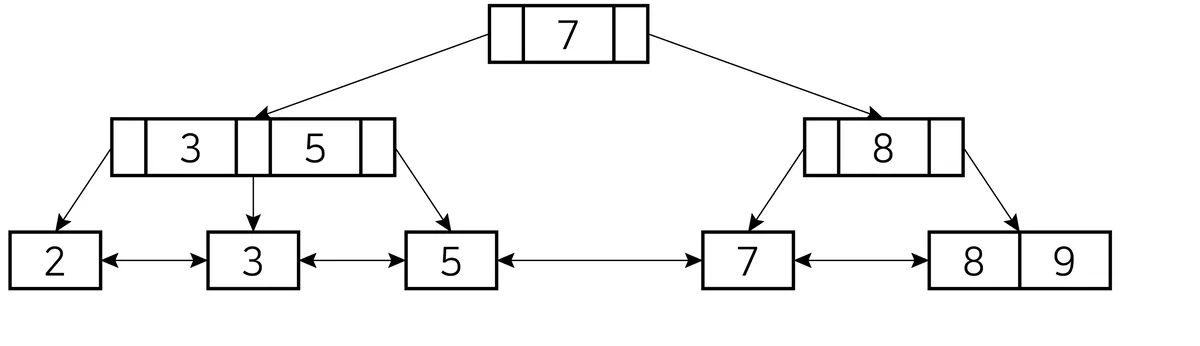
- ③
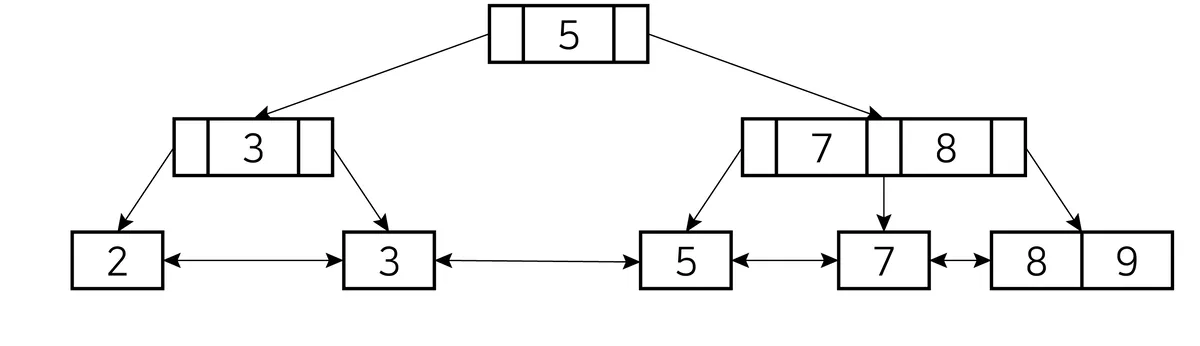
- ④
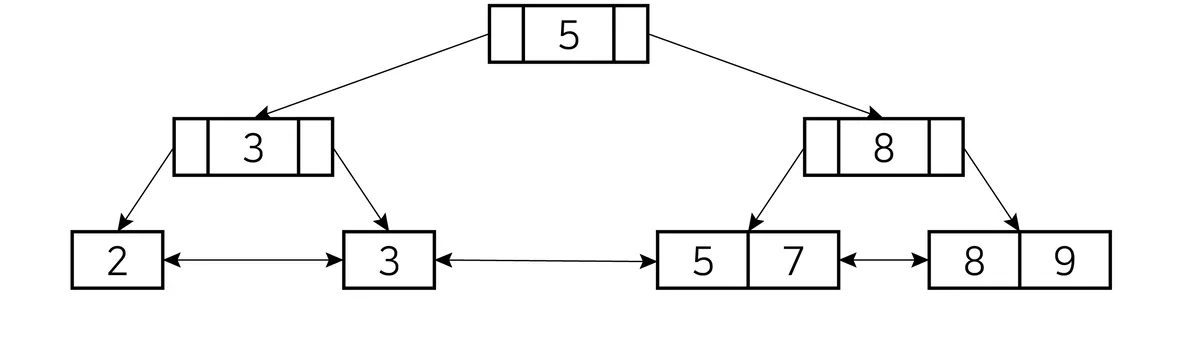
59번
관계형 데이터베이스의 질의 처리 방법에 대한 설명으로 옳은 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄹ
- ③
ㄴ, ㄷ
- ④
ㄷ, ㄹ
60번
다음 트랜잭션 T1, T2, T3 스케줄의 충돌 직렬 가능성 검사 시 충돌하는 연산으로 옳지 않은 것은?
시간 | T1 | T2 | T3 |
read(A) | |||
read(B) | |||
write(A) | |||
read(B) | |||
read(A) | |||
write(B) | |||
write(A) | |||
write(B) |
- ①
T1의 read(B)와 T2의 read(B)
- ②
T1의 write(B)와 T2의 write(B)
- ③
T2의 read(B)와 T1의 write(B)
- ④
T2의 write(A)와 T3의 read(A)
61번
다음 소프트웨어 개발 방법론과 모델링 도구를 바르게 연결한 것은?
(가) (나) (다)
- ①ABC
- ②ACB
- ③BCA
- ④CBA
62번
다음 중 응집도(cohesion)가 가장 높은 것은?
- ①
절차적(procedural) 응집도
- ②
시간적(temporal) 응집도
- ③
기능적(functional) 응집도
- ④
논리적(logical) 응집도
63번
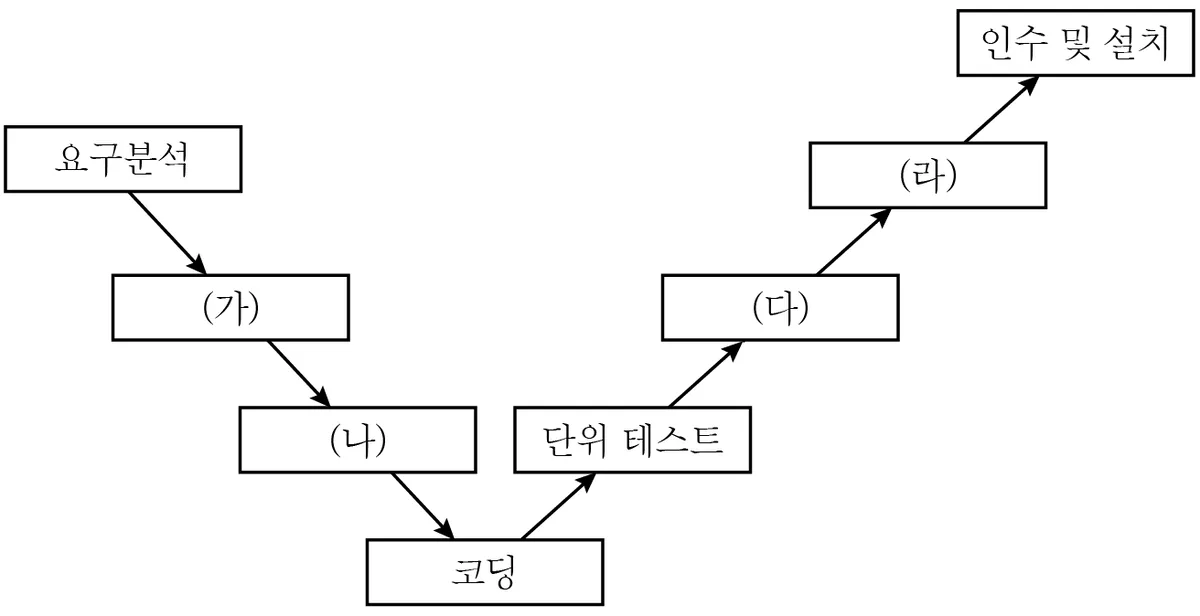
V 모델의 단계에서 (가) ~ (라)에 들어갈 내용을 바르게 연결한 것은?
(가) (나) (다) (라)
- ①ABCD
- ②ACBD
- ③CABD
- ④CADB
64번
(가)에 해당하는 시암 치댐버(Shyam R. Chidamber)와 크리스 캐머러(Chris F. Kemerer)의 객체지향 설계 척도는?
- ①
NOC(Number Of Children)
- ②
WMC(Weighted Methods per Class)
- ③
CBO(Coupling Between Object classes)
- ④
LCOM(Lack of Cohesion in Methods)
65번
다음과 같이 Java 코드를 변경하였을 때 적용된 기법은?
void select(int num)
{
  System.out.println("1. 한국어, 2. 영어");
  if(num == 1)
     System.out.println("한국어");
  else
     System.out.println("영어");
} |
|
void select(int num)
{
  System.out.println("1. 한국어, 2. 영어");
  lang(num);
}
void lang(int i)
{
  if(i == 1)
     System.out.println("한국어");
  else
     System.out.println("영어");
} |
- ①
리팩토링(refactoring)
- ②
재사용(reuse)
- ③
순공학(forward engineering)
- ④
역공학(reverse engineering)
66번
다음 Java 코드의 조건 커버리지(condition coverage)를 가장 크게 만족하는 테스트 케이스는? (단, 단축 연산(short-circuit evaluation)은 수행하지 않는다)
- ①
(x=10, y=10, z=4), (x=5, y=5, z=3)
- ②
(x=25, y=5, z=3), (x=8, y=5, z=3)
- ③
(x=10, y=10, z=4)
- ④
(x=25, y=5, z=3), (x=10, y=5, z=3), (x=5, y=5, z=1)
67번
다음 세부 품질 요소를 모두 포함하는 ISO/IEC 9126의 소프트웨어 품질 특성은?
- ①
신뢰성(reliability)
- ②
기능성(functionality)
- ③
사용성(usability)
- ④
안정성(stability)
68번
다음 파이썬 코드에 적용한 디자인 패턴은?
- ①
브릿지(bridge)
- ②
어댑터(adapter)
- ③
퍼사드(facade)
- ④
컴포지트(composite)
69번
중환자실 환자 모니터링 시스템은 생체신호 이상에 대한 신속한 경보, 환자 정보 보호, 경보 기능의 안전성, 24시간 서비스 가용성, 의료기기 변경에 대한 유지보수성이 중요하다. 이러한 요구사항을 고려한 아키텍처 설계 방안으로 옳은 것은?
- ①
신속한 처리가 필요한 경보 연산을 다수의 컴포넌트에 분산하여 상호 통신하도록 하고, 안전 관련 기능은 소수의 컴포넌트에 모아 배치한다.
- ②
신속한 경보에 필요한 핵심 연산은 소수의 컴포넌트에 집중하고, 변경이 잦은 의료기기 연동 기능은 작고 독립적인 컴포넌트로 구성한다.
- ③
안전 관련 기능은 가능한 여러 컴포넌트에 분산하고, 중요 환자 정보는 보호 수준이 높은 내부 계층에 배치한다.
- ④
높은 가용성을 위해 컴포넌트의 중복을 최소화하고, 유지보수성을 높이기 위해 여러 컴포넌트가 하나의 공유 데이터 구조를 사용하도록 한다.
70번
다음에 제시된 소프트웨어 유지보수 종류 (가) ~ (라)와 설명 A ~ D를 바르게 연결한 것은?
(가) (나) (다) (라)
- ①ADBC
- ②ADCB
- ③CABD
- ④CBAD
71번
객체 지향 설계 원칙에 대한 설명으로 옳지 않은 것은?
- ①
단일 책임(single-responsibility)의 원칙: 클래스를 변경해야 하는 이유는 오직 하나여야 한다.
- ②
개방 폐쇄(open-closed)의 원칙: 모듈은 수정에는 열려 있어야 하고 확장에는 닫혀 있어야 한다.
- ③
리스코프 대체(Liskov substitution)의 원칙: 상위 클래스의 객체는 자신의 하위 클래스로 대체할 수 있어야 한다.
- ④
의존 관계 역전(dependency inversion)의 원칙: 클라이언트는 구체적인 클래스가 아닌 추상 클래스에 의존해야 한다.
72번
「SW사업 대가산정 가이드(2025년)」 및 「소프트웨어사업 계약 및 관리감독에 관한 지침(2023년)」에 따라서 지능형 냉난방 조절 시스템 개발에 대한 평균 노력을 추정하고자 한다. 해당 시스템의 기능별 개수 및 평균 복잡도와 사업 규모별 1인 생산성이 <표 1> 및 <표 2>와 같이 주어졌을 때 평균 노력(MM)을 계산한 결과로 옳은 것은? (단, 필요한 보정 계수는 1.5로 계산한다)
<표 1> 기능별 개수 및 평균 복잡도 | ||
기능 유형 | 개수 | 평균 복잡도 |
외부입력 | 15 | 4.0 |
외부출력 | 5 | 5.2 |
외부조회 | 12 | 3.9 |
내부 논리 파일 | 4 | 7.5 |
외부 인터페이스 파일 | 2 | 5.4 |
<표 2> 사업 규모별 1인 생산성 | |
사업규모(FP) | 1인 생산성(FP/MM) |
1,000 미만 | 19 |
1,000 이상 ~ 2,000 미만 | 22 |
2,000 이상 ~ 3,000 미만 | 24 |
3,000 이상 | 22 |
- ①
약 0.25 MM
- ②
약 9.14 MM
- ③
약 13.71 MM
- ④
약 17.27 MM
73번
화이트박스 테스트 검증 기준에 대한 설명 중 옳지 않은 것은?
- ①
기본경로 테스트(basic path test)는 프로그램의 실행 흐름을 기준으로 원시 코드의 독립적인 경로가 최소 한 번은 실행되도록 테스트 케이스를 설계한다.
- ②
다중조건 커버리지(multiple condition coverage)는 프로그램 내의 결정문을 결정하는 조건의 참/거짓의 모든 조합이 실행될 수 있도록 테스트 케이스를 설계한다.
- ③
조건 커버리지(condition coverage)는 프로그램 내의 결정문을 결정하는 조건의 참/거짓이 최소한 한 번은 실행될 수 있도록 테스트 케이스를 설계한다.
- ④
조건/결정 커버리지(condition/decision coverage)는 분기를 결정하는 각 개별 조건식이 다른 개별 조건식에 영향을 받지 않고 전체 조건식의 결과에 독립적으로 영향을 주도록 테스트 케이스를 설계한다.
74번
CMMI에 대한 설명 중 옳지 않은 것은?
- ①
조직의 프로세스를 개선하기 위한 프레임워크로 소프트웨어 개발, 시스템 엔지니어링, 서비스 관리 등 다양한 도메인에서 활용될 수 있다.
- ②
CMMI 수준 평가는 성숙도 수준(maturity level)과 역량 수준(capability level)의 두 가지 수준을 평가하는 방법으로 나뉜다.
- ③
정의(defined) 수준에는 조직을 위한 표준 프로세스는 없고, 프로젝트별 프로세스만 있다.
- ④
협력 업체 관리는 성숙도 수준에서 관리(managed) 수준에 속하는 프로세스 영역이다.
75번
다음에서 설명하고 있는 프로젝트 관리 방법론의 주요 특징으로 옳지 않은 것은?
- ①
모든 설계 결정을 초기에 고정하고 변경을 최소화한다.
- ②
변화 요구에 대해 수용적이며 고객과의 지속적 협업을 강조한다.
- ③
반복적 개발을 통해 기능을 점진적으로 추가하며 배포한다.
- ④
문서화 중심이 아닌 실행 가능한 소프트웨어 중심의 개발 접근 방식이다.
76번
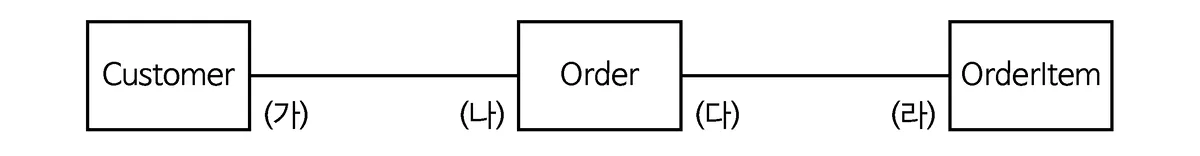
다음은 온라인 쇼핑몰 시스템의 도메인 모델을 나타낸 클래스 다이어그램의 일부에 대한 설명이다. 주어진 비즈니스 규칙을 바탕으로 도출한 다중성(multiplicity) 표기로 옳은 것은?
(가) (나) (다) (라)
- ①11..*11
- ②10..*11..*
- ③1..*10..*1..*
- ④0..*11..*1
77번
다음 요구사항 명세서에 대한 설명 중 옳지 않은 것은?
- ①
요구사항 ID: REQ-0001는 각 요구사항을 구분하는 유일한 식별자이다.
- ②
기능은 요구사항의 핵심 기능을 서술한다.
- ③
설명은 사용자 로그인 기능의 구현 방법을 상세히 기술한다.
- ④
제약조건은 요구사항의 조건이나 제한사항을 명확히한다.
78번
최근 소프트웨어 유지보수 및 운영 환경에서 필수적으로 적용되는 지속적 통합(CI), 지속적 배포(CD) 파이프라인과 데브옵스(DevOps) 환경에 대한 설명으로 옳지 않은 것은?
- ①
지속적 통합은 다수의 개발자가 작성한 소스 코드를 통합하여 소프트웨어 제품 형상을 개발하고 검증하는 프로세스를 말한다.
- ②
지속적 배포 단계에서 릴리스는 서버에 자원을 할당하고 인프라를 구축하여 최종 사용자에게 서비스를 오픈하는 단계를 의미하며, 설치는 배포 가능한 소프트웨어 패키지를 작성하는 단계를 의미한다.
- ③
데브옵스 환경에서는 코드의 품질을 유지하고 최상의 품질을 배포할 수 있도록 자동화 테스트 도구를 활용한다.
- ④
데브옵스에서는 소프트웨어가 정확히 동작하고 있는지 지속적으로 모니터링해야 하며, 모니터링 과정에서 발견된 문제에 대해 신속하게 대응한다.
79번
소프트웨어 품질 평가모델에 대한 설명으로 옳지 않은 것은?
- ①
ISO/IEC 9126은 내부품질/외부품질 및 사용품질로 구성되어 있으며 내부품질/외부품질 특성으로는 기능성, 사용성, 효율성, 신뢰성, 이식성, 유지보수성이 있다.
- ②
ISO/IEC 25000 시리즈는 ISO/IEC 9126과 ISO/IEC 14598 시리즈를 통합한 프레임워크로 품질 모델 영역, 품질 측정 영역 등 4개 영역으로 구성된다.
- ③
ISO/IEC 14598은 소프트웨어의 개발 과정 또는 완성된 제품에 대해 공급자와 구매자가 객관적으로 품질을 평가할 수 있도록 절차와 방법을 정의한 국제표준으로 평가지원 부분과 평가 프로세스로 구성한다.
- ④
ISO/IEC 12119는 테스트의 절차와 결과의 일관성을 확보하기 위한 지침을 제공하며 패키지 소프트웨어의 품질 요구사항을 정의한다.
80번
객체지향 분석 및 설계 과정에서 시스템의 모델링을 위해 다양한 UML 다이어그램이 활용된다. 다음 도서 관리 시스템 개발 시나리오에 적용할 가장 적절한 UML 다이어그램을 바르게 연결한 것은?
(가) (나) (다)
- ①BCA
- ②ADC
- ③CDA
- ④ACB
제출하면 채점되고 결과 카드가 만들어집니다. 제출 전에는 정답을 볼 수 없습니다.