1번
분할 정복(divide-and-conquer) 방식의 정렬 알고리즘에 대한 설명으로 옳지 않은 것은?
- ①
2-way 합병 정렬의 분할은 분할 대상을 반으로 나눈다.
- ②
퀵정렬(quick sort)의 분할은 분할 대상에 대하여 피봇(pivot)을 기준으로 나눈다.
- ③
합병 정렬과 다르게 퀵정렬에서는 모든 분할이 완료되면 정렬도 완료된다.
- ④
합병 정렬은 추가 데이터 저장공간이 필요 없는 제자리 정렬 알고리즘이다.
2번
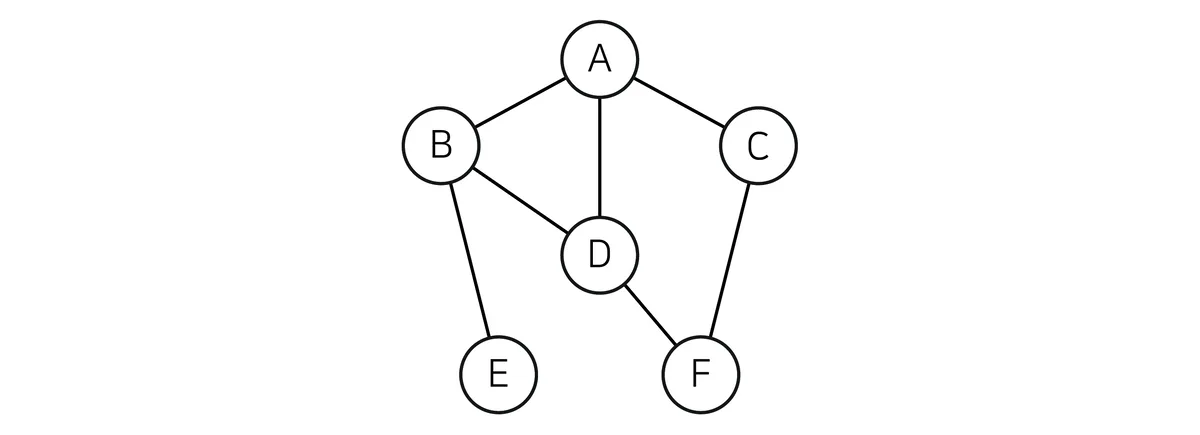
다음 그래프에서 정점 A부터 깊이 우선 탐색을 수행할 때 가능한 정점들의 방문 순서로 옳은 것은?
- ①
A → B → E → F → D → C
- ②
A → B → D → C → E → F
- ③
A → D → B → E → F → C
- ④
A → D → F → E → B → C
3번
그리디 알고리즘에 해당하는 것은?
- ①
크루스칼(Kruskal) 알고리즘
- ②
0/1 배낭(knapsack) 문제 풀이
- ③
플로이드-워셜(Floyd-Warshall) 알고리즘
- ④
최장 공통 부분 수열(LCS, Longest Common Subsequence) 구하기
4번
다음 C언어 함수 ABC()에 대한 설명으로 옳은 것은?
- ①
코드 수행 완료 후, A[0]에는 가장 큰 원소가 저장되어 있다.
- ②
코드 수행 완료 후, 배열 A의 원소는 오름차순으로 정렬되어 있다.
- ③
최선의 경우와 최악의 경우의 수행 시간 복잡도가 다르다.
- ④
코드는 삽입 정렬(insertion sort)을 구현한 것이다.
5번
문제를 해결하기 위한 알고리즘 개발 단계를 순서대로 바르게 나열한 것은?
- ①
(나) → (다) → (라) → (가)
- ②
(나) → (라) → (다) → (가)
- ③
(다) → (나) → (라) → (가)
- ④
(다) → (라) → (나) → (가)
6번
다음 파이썬 프로그램의 실행 결과는?
- ①
[6, 4, 2, 1, 3, 8, 5, 7, 9, 10]
- ②
[6, 4, 2, 1, 5, 8, 3, 7, 9, 10]
- ③
[6, 4, 2, 1, 3, 5, 8, 7, 9, 10]
- ④
[6, 4, 2, 1, 5, 3, 8, 7, 9, 10]
7번
다음은 어떤 문자열에 포함된 문자들의 빈도수를 나타낸 표이다. 허프만(Huffman) 코드를 적용하여 인코딩한 결과의 비트 수는?
문자 | a | b | c | d | e | f |
빈도수 | 7 | 20 | 10 | 5 | 50 | 6 |
- ①
98
- ②
202
- ③
300
- ④
331
8번
다음 설명에 해당하는 정렬 알고리즘은?
- ①
삽입 정렬
- ②
버블 정렬
- ③
병합(merge) 정렬
- ④
선택(selection) 정렬
9번
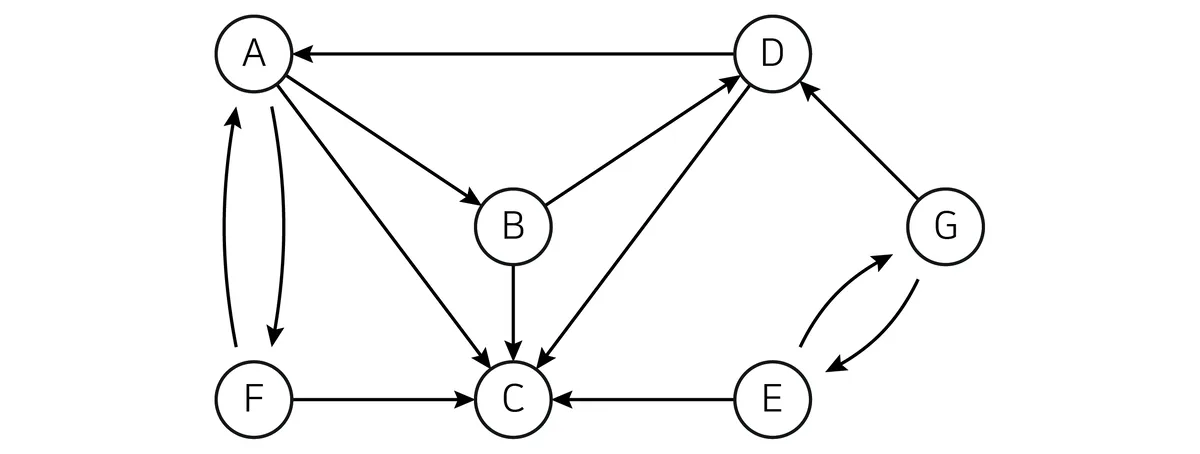
다음 조건에 따라 주어진 그래프에 대해 깊이 우선 탐색(DFS, Depth First Search) 방법을 이용하여 트리를 만들 경우, 나올 수 있는 트리의 개수와 수행하는 백트래킹 횟수를 바르게 연결한 것은?
트리의 개수 백트래킹 횟수
- ①13
- ②14
- ③23
- ④25
10번
위상 정렬(topological sort)에 대한 설명으로 옳은 것은?
- ①
깊이 우선 탐색 방식을 이용해서는 구현할 수 없다.
- ②
하나의 그래프에 한 개의 위상 정렬만 존재한다.
- ③
사이클이 없는 모든 종류의 그래프에 적용할 수 있다.
- ④
간선 <i, j>를 가질 때 정점 i는 정점 j를 선행한다.
11번
문자열 매칭을 위한 알고리즘으로 옳은 것은?
- ①
합병 정렬 알고리즘
- ②
라빈 카프(Rabin-Karp) 알고리즘
- ③
백트래킹(backtracking) 알고리즘
- ④
후위 순회(postorder traversal) 알고리즘
12번
점근 표기법에 대한 설명으로 옳은 것은?
- ①
알고리즘의 수행 시간을 대략적으로 나타내는 방법이다.
- ②
(Big-oh) 표기는 최소한의 알고리즘 수행 시간을 나타내기 위해 사용한다.
- ③
n개 정수 배열에 대한 순차 탐색 알고리즘은 (1) 시간 복잡도를 가진다.
- ④
증가 함수 는 으로 표기할 수 있다.
13번
다음 설명에 해당하는 알고리즘은?
- ①
유클리드(Euclid) 알고리즘
- ②
스트라센(Strassen) 알고리즘
- ③
몬테카를로(Monte Carlo) 알고리즘
- ④
플로이드-워샬(Floyd-Warshall) 알고리즘
14번
그래프의 임의의 한 점에서 출발하여 다른 모든 점을 한 번씩만 방문하고, 다시 시작점으로 돌아오는 경로 중 최단 경로를 찾는 문제는?
- ①
통 채우기(bin packing) 문제
- ②
정점 커버(vertex cover) 문제
- ③
그래프 색칠하기(graph coloring) 문제
- ④
여행자 문제(TSP, Traveling Salesman Problem)
15번
다음 중 안정적 정렬(stable sort) 알고리즘에 해당하는 것만을 모두 고르면?
- ①
ㄴ, ㄷ
- ②
ㄴ, ㄹ
- ③
ㄱ, ㄴ, ㄷ
- ④
ㄱ, ㄷ, ㄹ
16번
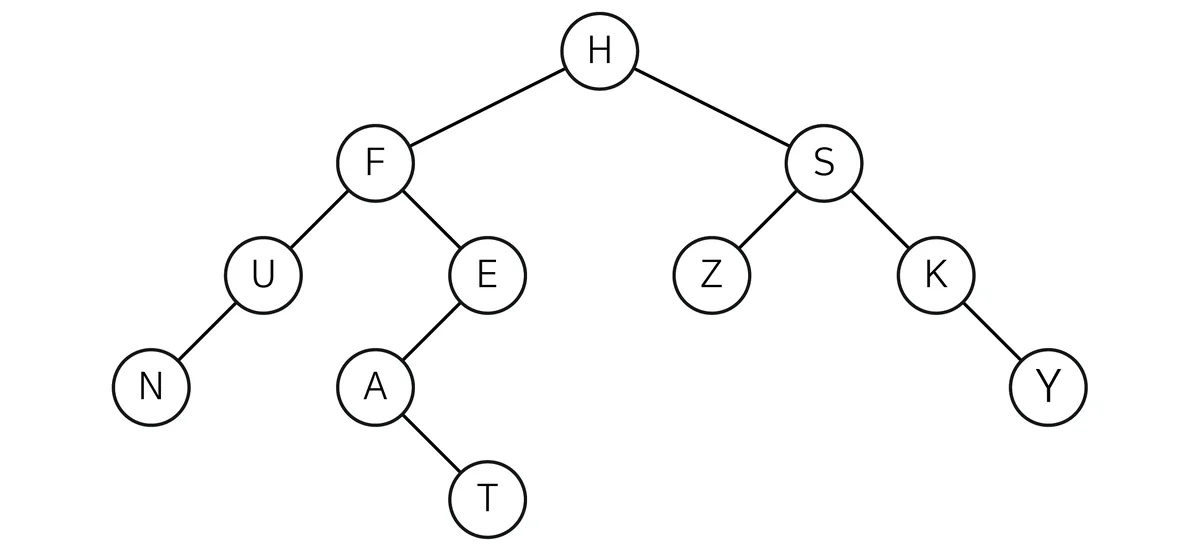
그림과 같이 연결되어 있는 11개의 여행지를 관광객들이 모두 방문할 수 있도록 안내하기 위해 C언어로 구현한 Course() 함수를 다음과 같이 제시하고 있다. 여행지 H를 파라미터로 하여 알고리즘을 호출했을 때, 출력결과의 (가) ~ (라)에 들어갈 내용을 바르게 연결한 것은? (단, 상위 노드 기준으로 n->left는 왼쪽으로 순회하고 n->right는 오른쪽으로 순회한다)
(가) (나) (다) (라)
- ①HAZK
- ②HTSK
- ③NHUT
- ④NTES
17번
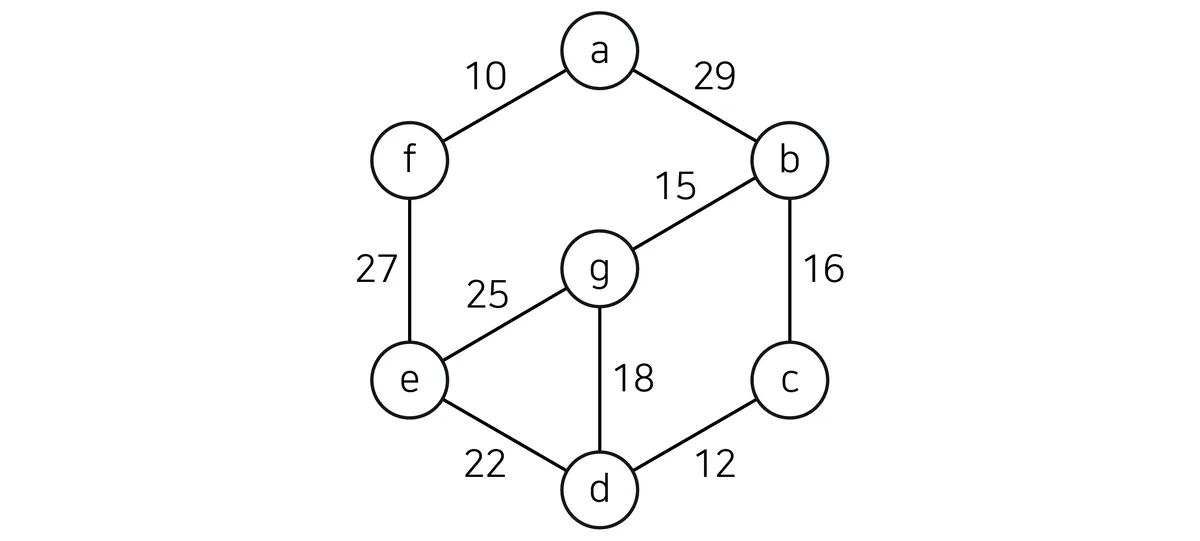
다음 그래프를 대상으로 크루스칼(Kruskal) 알고리즘을 적용하여 최소 신장 트리(MST, Minimum Spanning Tree)를 구성하고자 할 때, 생성되는 MST에 5번째 추가되는 간선과 비용을 바르게 연결한 것은?
간선 비용
- ①(b, c)16
- ②(d, g)18
- ③(d, e)22
- ④(e, g)25
18번
다음은 초기상태 배열을 오름차순으로 정렬하는 단계들이다. 이와 같이 정렬을 수행하는 알고리즘으로 옳은 것은?
- ①
선택 정렬(selection sort)
- ②
버블 정렬(bubble sort)
- ③
합병 정렬(merge sort)
- ④
기수 정렬(radix sort)
19번
정렬 알고리즘에 대한 설명으로 옳은 것은?
- ①
힙 정렬의 시간 복잡도는 이다.
- ②
퀵 정렬은 정렬할 전체 원소에 대해 정렬을 수행한 후 기준값을 중심으로 왼쪽 부분집합과 오른쪽 부분집합으로 분할한다.
- ③
삽입 정렬은 입력에 민감한 알고리즘으로, 입력이 거의 정렬되어 있을 때 처리시간이 느리고, 입력이 역으로 정렬되어 있을 때는 최선의 경우로 빠르다.
- ④
병합 정렬은 크기가 n인 입력을 n/2 크기로 분할하고, 각각에 대해 같은 방식으로 정렬을 수행한 후, 2개의 각각 정렬된 부분을 합병한다.
20번
동적 프로그래밍(dynamic programming) 방법으로 최소의 원소단위 곱셈 횟수를 갖도록 연쇄 행렬곱셈(matrix-chain multiplication)의 순서를 정하려 한다. 를 행렬 부터 까지의 연쇄 행렬곱셈의 최소 비용이라고 할 때, 에 대한 관계식으로 옳은 것은? (단, 이고, 각 행렬의 차원이 일 때, 행렬 의 크기는 이다)
- ①
- ②
- ③
- ④
21번
인공지능 생성모델에 해당하지 않는 것은?
- ①
Diffusion Model
- ②
DQN(Deep Q-Network)
- ③
GANs(Generative Adversarial Networks)
- ④
VAEs(Variational Autoencoders)
22번
2017년 발표된 아실로마 인공지능 원칙(Asilomar AI principles)에 대한 설명으로 옳지 않은 것은?
- ①
인공지능 개발의 목적, 윤리, 가치 등에 대해 23가지 원칙을 제시했다.
- ②
인공지능 시스템은 반드시 인간의 직접적인 통제 없이 자율적으로 작동해야 한다.
- ③
연구 목표는 방향성이 없는 지능이 아니라 인간에게 유용한 지능 개발이어야 한다.
- ④
인공지능 시스템의 실패 원인을 이해할 수 있도록 투명성과 설명 가능성이 확보되어야 한다.
23번
데이터 1,000개를 대상으로 5-폴드 교차검증을 수행할 때, 한 번의 반복에서 사용되는 훈련 데이터와 검증 데이터의 개수는? (단, 각 폴드의 크기는 같다고 가정한다)
훈련 데이터 개수 검증 데이터 개수
- ①200800
- ②500500
- ③800200
- ④1,0001,000
24번
추천 시스템(recommender system)의 유형 중 협업 기반 추천과 내용 기반 추천에 대한 설명으로 옳지 않은 것은?
- ①
내용 기반 추천은 메모리 기반 방법과 모델 기반 방법이 있고 콜드 스타트(cold start) 문제가 발생한다.
- ②
아이템 기반 추천은 이전에 구매한 아이템을 기반으로 그 상품과 유사한 다른 상품을 추천하는 방법이다.
- ③
사용자 기반 추천은 나와 비슷한 성향을 지닌 사용자의 데이터를 기반으로 상품을 추천하는 방법이다.
- ④
추천 시스템은 콘텐츠의 내용에 기반하거나 사람들의 성향 정보를 취득한 후 개인화된 맞춤 항목을 추천한다.
25번
시간성을 갖는 데이터에 유용하고 문맥 의존성을 효율적으로 처리할 수 있는 신경망은?
- ①
CNN
- ②
KNN
- ③
MLP
- ④
RNN
26번
다음 문장에서 바이그램(bigram) 언어 모델을 사용할 때, ‘나는 학교에’ 다음에 ‘간다’가 나올 확률을 계산하는 올바른 식은?
- ①
P(간다)
- ②
P(간다 | 나는)
- ③
P(간다 | 학교에)
- ④
P(간다 | 나는, 학교에)
27번
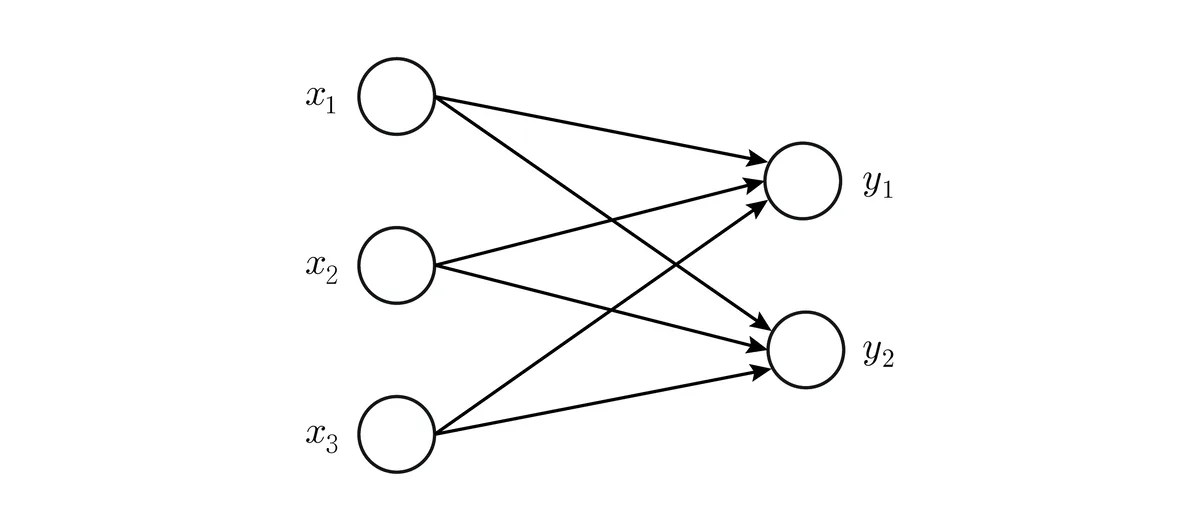
다음 퍼셉트론 신경망에서 학습이 가능한 데이터 세트는?
- ①
0
0
0
0
0
0
0
1
0
1
1
1
0
1
0
1
1
1
1
1
- ②
0
0
0
0
0
0
0
1
0
1
1
1
0
1
1
1
1
1
1
0
- ③
0
0
0
0
0
0
0
1
1
0
1
1
0
1
1
1
1
1
0
1
- ④
0
0
0
0
1
0
1
0
1
1
1
0
1
1
0
1
1
1
0
0
28번
규칙 기반 시스템에 대한 설명으로 옳지 않은 것은?
- ①
경합 해소(conflict resolution)는 여러 규칙을 동시에 실행할 경우 모순이 발생할 수 있기 때문에 실행 가능한 규칙들 중에서 한 개를 선택하는 것을 의미한다.
- ②
전향 추론(forward chaining)은 규칙의 조건부를 만족시키는 사실이 있을 때 규칙의 결론부를 실행하거나 처리한다.
- ③
후향 추론(backward chaining)은 특정 사실을 확인하기 위해 해당 사실을 결론부에 포함하는 규칙의 조건부가 만족하는지 확인해 가는 방식으로 추론한다.
- ④
추론 엔진(inference engine)은 경합 해소 → 패턴 매칭(pattern matching) → 규칙 실행(rule execution)의 과정을 반복하여 추론한다.
29번
탐색 방법에 대한 설명으로 옳지 않은 것은?
- ①
맹목적 탐색은 문제의 상태 공간 정보를 이용한다.
- ②
깊이 우선 탐색은 너비 우선 탐색에 비해 메모리에 대한 부담이 적지만 최단 경로를 찾는다는 보장이 없다.
- ③
너비 우선 탐색은 목표 상태를 찾을 때까지 생성된 모든 노드를 메모리에서 관리하기 때문에 메모리 비용이 크다.
- ④
반복적 깊이 심화 탐색은 탐색 깊이 한계를 0부터 점차 증가시키면서 깊이 우선으로 탐색하는 방법이고 최단 경로 찾는 것을 보장한다.
30번
연합학습(federated learning)의 학습 과정을 순서대로 바르게 나열한 것은?
- ①
(가) → (다) → (라) → (나)
- ②
(가) → (라) → (다) → (나)
- ③
(다) → (가) → (라) → (나)
- ④
(다) → (라) → (가) → (나)
31번
빅데이터 분석을 위한 데이터 마이닝에 대한 설명으로 옳지 않은 것은?
- ①
정제되지 않은 대용량의 데이터로부터 의미 있는 상관관계, 패턴, 추세 등을 발견한다.
- ②
트랜잭션에서 항목 간의 불순도를 표현하기 위해 최소지지도와 최소신뢰도를 사용한다.
- ③
저장된 데이터를 정제(cleaning), 통합(integration)하여 잡음과 불일치를 제거하고 데이터 웨어하우스에 저장한다.
- ④
대규모 데이터에서 암묵적인, 이전에 알려지지 않은, 잠재적으로 유용할 것 같은 정보나 지식을 추출하는 체계적인 과정이다.
32번
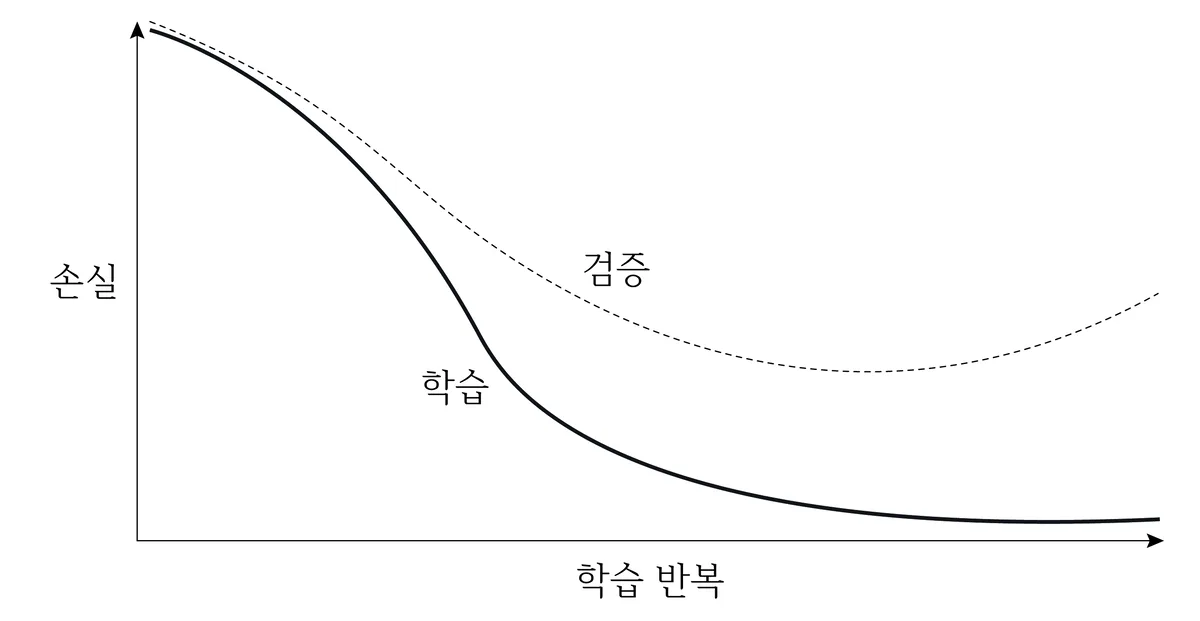
신경망에서 학습의 진행에 따른 학습 데이터의 손실값과 검증 데이터의 손실값이 다음과 같을 때, 이에 대한 설명으로 옳지 않은 것은?
- ①
학습 데이터를 추가하여 검증 손실값을 학습 손실값에 근접시킬 수 있다.
- ②
신경망 학습 모델이 학습 데이터 세트의 패턴을 적절히 학습하지 못했다는 의미이다.
- ③
신경망의 은닉층 개수, 뉴런의 개수 등 학습 매개 변수가 과도하게 많으면 발생할 수 있다.
- ④
신경망에서 검증 손실값이 다시 상승하는 현상을 완화하기 위하여 가중치 규제 방법이 사용될 수 있다.
33번
(가) ~ (다)의 효율적 파인튜닝(Parameter-Efficient Fine-tuning) 기법과 이에 대한 설명을 바르게 연결한 것은? (단, 각 기법에서는 사전 학습된 모델의 기존 가중치를 고정(freeze)한다)
(가) (나) (다)
- ①ABC
- ②ACB
- ③BAC
- ④CAB
34번
운전면허 시험 성적에서 합격 6명, 불합격 4명으로 구성된 데이터 세트의 지니 계수(Gini index) 값은?
- ①
0.25
- ②
0.48
- ③
0.52
- ④
1
35번
CLIP(Contrastive Language-Image Pretraining)에 대한 설명으로 옳지 않은 것은?
- ①
사전훈련을 통해 텍스트 데이터를 학습해 놓은 모델인 트랜스포머 언어 모델을 기반으로 한다.
- ②
이미지와 텍스트를 각각 임베딩 공간에 표현하고, 서로 대응하는 이미지와 텍스트의 유사도가 높아지도록 대조 학습(contrastive learning)을 수행한다.
- ③
제로 샷(zero-shot) 예측과는 달리, 클래스를 추가하고 모델을 재학습하여 새로운 입력 이미지를 분류할 수 있다.
- ④
시각 정보와 언어 정보 사이의 대응 관계를 학습한 멀티 모달 모델로 이미지 검색, 이미지 설명 생성, 시각 질의응답 등 다양한 작업으로 확장할 수 있다.
36번
퍼셉트론(perceptron)에 대한 설명으로 옳지 않은 것은?
- ①
퍼셉트론의 하이퍼 매개 변수(hyper parameter)를 정하는 것은 사람이 해야 한다.
- ②
단층 퍼셉트론이 해결할 수 있는 문제는 비선형 영역을 포함한다.
- ③
퍼셉트론은 다수의 신호를 입력으로 받아 하나의 신호를 출력한다.
- ④
단층 퍼셉트론의 구성 요소 중 임곗값은 바이어스(bias)로 대체할 수 있다.
37번
(가)에 해당하는 인공지능 개념은?
- ①
분기점(branch point)
- ②
임계점(critical point)
- ③
전환점(turning point)
- ④
특이점(singularity)
38번
이진 분류 모델의 실젯값과 예측값이 다음과 같이 계산되었을 때, F1 점수(score)의 근삿값은? (단, 1을 positive로 가정한다)
실젯값 | 1 | 0 | 1 | 0 | 1 | 0 | 1 | 0 |
예측값 | 1 | 0 | 0 | 0 | 1 | 1 | 0 | 0 |
- ①
0.33
- ②
0.5
- ③
0.57
- ④
0.75
39번
다음 조건에서 어떤 검사자가 진단키트를 한 번 사용하여 양성 반응을 보였을 때, 그 사람이 실제로 A 암에 걸려 있을 확률은?
- ①
약 0.01
- ②
약 0.05
- ③
약 0.95
- ④
약 0.99
40번
선형 회귀에서 평균제곱오차(MSE)를 최소화하는 계수를 찾는 방법은?
- ①
주성분 분석법
- ②
선형 판별 분석법
- ③
최소우도법
- ④
최소제곱법
41번
재사용이 불가능하도록 매번 새로운 패스워드를 생성하는 인증 방식은?
- ①
SSO
- ②
OTP
- ③
PIN
- ④
RADIUS
42번
정보보호 최고책임자 또는 개인정보 보호책임자를 지정하도록 하는 근거가 되는 법률이 아닌 것은?
- ①
개인정보 보호법
- ②
전자금융거래법
- ③
정보보호산업의 진흥에 관한 법률
- ④
정보통신망 이용촉진 및 정보보호 등에 관한 법률
43번
DNS 스푸핑 공격에 대한 설명으로 옳지 않은 것은?
- ①
사용자가 악의적인 웹 사이트에 접속하도록 하는 공격이다.
- ②
공격자는 사용자의 DNS 질의에 대해 위조된(spoofed) 응답이 사용자에게 전달되게 한다.
- ③
DNS 캐시 포이즈닝(poisoning)은 위조된 DNS 응답이 로컬 DNS 서버의 캐시에 저장되므로 일정 기간 사용자에게 피해를 줄 수 있다.
- ④
디지털 서명으로 DNS 데이터그램의 진위 여부를 확인할 수 있는 SSH(Secure Shell)가 DNS 캐시 포이즈닝 공격을 방지하기 위해 설계되었다.
44번
다음 설명의 (가), (나), (다)에 들어갈 용어를 바르게 연결한 것은?
(가) (나) (다)
- ①NAC방화벽IPS
- ②IPSDRM방화벽
- ③NACIPSIDS
- ④DRMIDSNAC
45번
ISMS-P 인증 추진체계에서 인증기관에 해당하는 것은?
- ①
금융보안원(FSI)
- ②
한국정보통신진흥협회(KAIT)
- ③
한국정보통신기술협회(TTA)
- ④
개인정보보호협회(OPA)
46번
AES에 대한 설명으로 옳지 않은 것은?
- ①
SPN 구조를 사용한다.
- ②
128비트 블록 단위로 암호화한다.
- ③
암호화 함수와 복호화 함수가 동일하다.
- ④
키 길이에 따라 10, 12, 14 라운드로 구성된다.
47번
IPSec ESP(Encapsulating Security Payload)의 패킷 포맷에 대한 설명으로 옳지 않은 것은?
- ①
32비트의 보안 매개변수 색인(security parameter index) 필드에는 같은 보안연관(security association)에 속하는 각 패킷에 대해 서로 다른 보안 매개변수 색인값이 주어진다.
- ②
32비트의 순서 번호(sequence number) 필드에는 데이터그램의 순서를 나타내는 카운터 값이 저장된다.
- ③
8비트의 다음 헤더(next header) 필드는 IP 데이터그램에 의해 전달되는 페이로드의 데이터 유형을 나타낸다.
- ④
ICV(Integrity Check Value) 필드에는 IP 헤더와 ICV를 제외한 전체 패킷에 대해 계산한 인증 데이터가 저장된다.
48번
「개인정보 보호법」상 공개된 장소에 고정형 영상정보처리기기를 설치ㆍ운영할 수 있는 경우가 아닌 것은?
- ①
범죄의 예방 및 수사를 위하여 필요한 경우
- ②
시설의 안전 및 관리, 화재 예방을 위하여 정당한 권한을 가진 자가 설치ㆍ운영하는 경우
- ③
교통정보의 수집ㆍ분석 및 제공을 위하여 정당한 권한을 가진 자가 설치ㆍ운영하는 경우
- ④
촬영된 영상정보를 저장하지 아니하는 경우로서 개인정보보호위원회가 정하는 경우
49번
다음은 정보보호의 요구사항에 대한 설명이다. (가)에 들어갈 용어는?
- ①
기밀성
- ②
인증성
- ③
무결성
- ④
가용성
50번
리눅스 /etc/group 파일의 4개 필드에 대한 설명으로 옳지 않은 것은?
- ①
첫 번째 필드는 그룹의 이름을 나타낸다. groupadd 명령을 이용하여 새로운 그룹을 생성할 수 있다.
- ②
두 번째 필드는 그룹 패스워드를 나타내는 부분이지만 /etc/gshadow 파일에서 별도 관리하는 경우에는 ‘x’로만 표기된다.
- ③
세 번째 필드는 리눅스에서 그룹에 부여한 번호로 그룹 생성 이후에는 변경할 수 없다.
- ④
네 번째 필드에 해당 그룹에 속한 사용자의 로그인 ID가 기록된다.
51번
반사형 XSS 공격에 대한 설명으로 옳은 것은?
- ①
악성 스크립트가 웹 서버에서 실행된다.
- ②
악성 스크립트는 웹 서버 측 데이터베이스에 저장된다.
- ③
공격자가 보낸 악의적 링크를 사용자가 클릭하게 한다.
- ④
사용자와 웹 서버 간의 신뢰 관계를 악용하여 공격자가 원하는 서버 동작을 발생시킨다.
52번
리눅스의 find 명령에 대한 설명으로 옳지 않은 것은?
- ①
명령: find / -name '*.c'
설명: 확장자가 c인 파일을 모두 찾는다.
- ②
명령: find / -mtime -2
설명: 최근 48시간 이내에 마지막으로 수정된 파일을 모두 찾는다.
- ③
명령: find / -user user1
설명: 소유자가 user1인 파일을 모두 찾는다.
- ④
명령: find / -type 4755
설명: 권한 설정이 4755로 설정된 파일을 모두 찾는다.
53번
다음 설명에 해당하는 암호학적 해시함수 h의 특성은?
- ①
무결성(integrity)
- ②
일방향성(one-way property)
- ③
강한 충돌 저항성(strong collision resistance)
- ④
약한 충돌 저항성(weak collision resistance)
54번
기업망을 보호하기 위해 네트워크 경계를 신뢰 판단의 전제로 삼지 않고, 위치와 관계없이 모든 접근을 지속적으로 검증하고, 최소 권한만 부여하는 보안 방식은?
- ①
다중 인증(Multi-factor Authentication)
- ②
챌린지 핸드셰이크 인증 프로토콜(Challenge Handshake Authentication Protocol)
- ③
제로 트러스트 보안 모델(Zero Trust Security Model)
- ④
임의적 접근 통제 모델(Discretionary Access Control Model)
55번
다음에서 설명하는 접근제어 과정은?
- ①
Identification
- ②
Authorization
- ③
Authentication
- ④
One-Time Password
56번
정보보안 목표와 그 목표에 대한 위협 요소를 바르게 연결한 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄷ
- ③
ㄴ, ㄷ
- ④
ㄱ, ㄴ, ㄷ
57번
「클라우드컴퓨팅 발전 및 이용자 보호에 관한 법률 시행령」에 따른 클라우드컴퓨팅서비스의 보안인증 절차 등에 대한 설명으로 옳지 않은 것은?
- ①
한국인터넷진흥원은 클라우드컴퓨팅서비스에 대한 보안인증 기관의 하나이다.
- ②
국가기관 등이 이용하는 클라우드컴퓨팅서비스의 보안인증 기준은 국가정보원장이 정한다.
- ③
보안인증의 유효기간은 5년이다.
- ④
보안인증의 유효기간은 연장할 수 있다.
58번
암호에 대한 설명으로 옳지 않은 것은?
- ①
공개키 암호 알고리즘은 트랩도어 단방향 함수에 기반을 둔다.
- ②
대칭키 암호 알고리즘은 공개키 암호 시스템에 비해서 암호화 및 복호화 속도가 빠르다.
- ③
공개키 암호 알고리즘의 대표적인 알고리즘은 DES이다.
- ④
공개키 암호는 전자서명에 사용된다.
59번
양자 컴퓨터 시대의 암호에 대한 설명으로 옳은 것은?
- ①
AES는 키 길이를 증가시켜도 더 이상 안전성을 유지할 수 없다.
- ②
양자 키 분배 프로토콜을 사용하면 안전하게 암호키를 공유할 수 있다.
- ③
양자내성암호(PQC)는 양자 알고리즘을 이용하여 양자 컴퓨터에서만 동작하도록 설계된 암호이다.
- ④
인수분해의 어려움에 의존하는 RSA는 쇼어(Shor) 알고리즘을 이용한 양자 컴퓨터의 공격에도 안전성을 유지할 수 있다.
60번
다음 설명에 해당하는 것은?
- ①
TrustZone
- ②
SIEM(Security Information & Event Management)
- ③
TEE(Trusted Execution Environment)
- ④
TPM(Trusted Platform Module)
61번
다음 ‘고객’ 테이블과 ‘주문’ 테이블에서 아래에 주어진 SQL문과 동일한 결과를 출력하는 SQL문은? (단, 밑줄 속성은 기본키이며, ‘주문’ 테이블의 고객번호는 ‘고객’ 테이블의 번호를 참조하는 외래키이다)
고객 | ||
번호 | 이름 | 성별 |
1001 | 김홍도 | M |
1002 | 허균 | M |
1003 | 유관순 | F |
주문 | ||
고객번호 | 제품번호 | 개수 |
1001 | AA | 1 |
1003 | AA | 1 |
1001 | BA | 2 |
- ①
SELECT 이름, 제품번호, 개수
FROM 고객 OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ②
SELECT 이름, 제품번호, 개수
FROM 고객 RIGHT OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ③
SELECT 이름, 제품번호, 개수
FROM 고객 LEFT OUTER JOIN 주문
ON 번호 = 고객번호
ORDER BY 이름, 제품번호;
- ④
SELECT 이름, 제품번호, 개수
FROM 고객, 주문
WHERE 번호 IN (SELECT 고객번호 FROM 주문)
ORDER BY 이름, 제품번호;
62번
‘주문’, ‘제품1’, ‘제품2’ 테이블에 대하여 ‘주문 ÷ 제품1’, ‘주문 ÷ 제품2’의 연산 결과로 옳은 것은?
주문 | 제품1 | 제품2 | |||||
주문고객 | 제품이름 | 제조업체 | 제품이름 | 제조업체 | 제품이름 | ||
C1 | 라면 | P1 | 음료 | P1 | 라면 | ||
C2 | 과자 | P2 | 음료 | ||||
C3 | 음료 | P1 | |||||
C1 | 음료 | P1 | |||||
C2 | 음료 | P1 | |||||
주문 ÷ 제품1 주문 ÷ 제품2
- ①
주문고객
주문고객
제조업체
C3
C1
P1
C1
C2
- ②
주문고객
주문고객
제조업체
C1
C2
P2
C2
- ③
주문고객
제품이름
제조업체
주문고객
제품이름
제조업체
C3
음료
P1
C1
라면
P1
C1
음료
P1
C1
음료
P1
C2
음료
P1
- ④
주문고객
제품이름
제조업체
주문고객
제품이름
제조업체
C1
라면
P1
C2
과자
P2
C2
과자
P2
63번
데이터베이스의 무결성 제약조건에 대한 설명으로 옳지 않은 것은?
- ①
참조 무결성 제약조건은 외래키는 참조할 수 없는 값을 가질 수 없다는 규칙이다.
- ②
개체 무결성 제약조건은 기본키를 구성하는 모든 속성은 NULL 값을 가지면 안 된다는 규칙이다.
- ③
기본키로 정의된 속성은 중복된 값이 허용되지 않는다.
- ④
참조 무결성 제약조건에서 자식 릴레이션은 부모 릴레이션의 제약을 받지 않는다.
64번
저장 프로시저(stored procedure)에 대한 설명으로 옳지 않은 것은?
- ①
일반 애플리케이션 함수와 달리 매개변수를 전달할 수 없다.
- ②
데이터베이스 서버에서 실행되어 클라이언트와 서버 사이의 데이터 전송량을 줄일 수 있다.
- ③
SQL 외에 다른 언어로 작성될 수 있다.
- ④
CALL 문장을 가진 대화형 SQL에서 호출될 수 있다.
65번
관계형 데이터베이스에서 질의 최적화를 위한 조인 연산 처리에 대한 설명으로 옳은 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄷ
- ③
ㄴ, ㄷ
- ④
ㄱ, ㄴ, ㄷ
66번
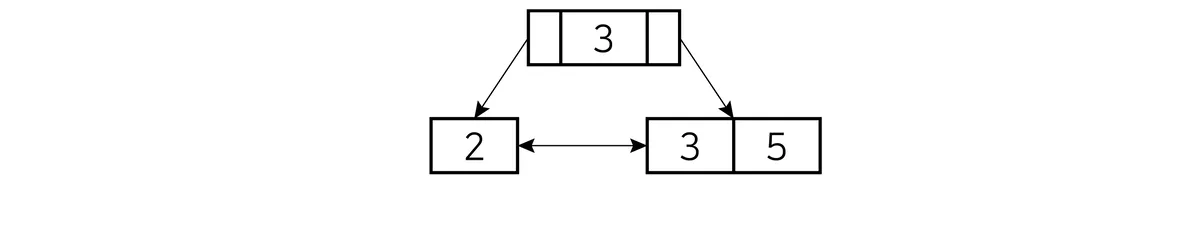
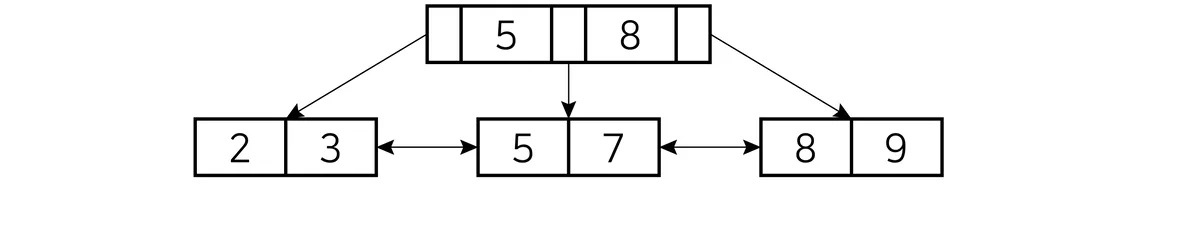
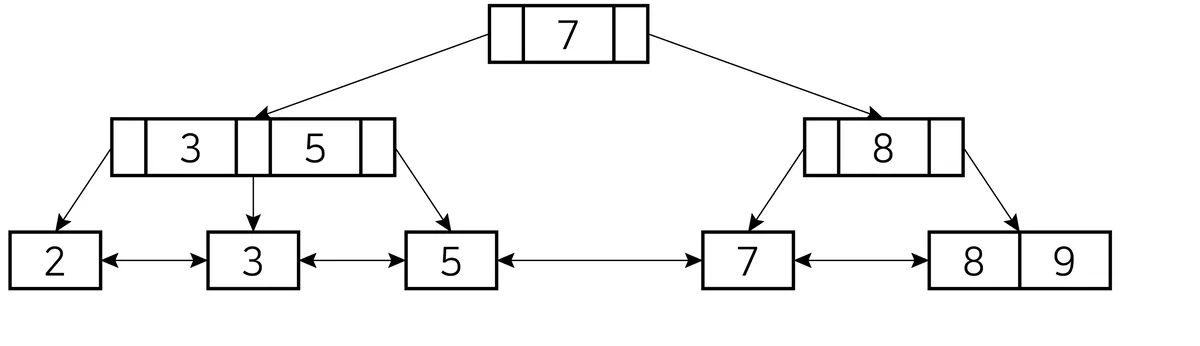
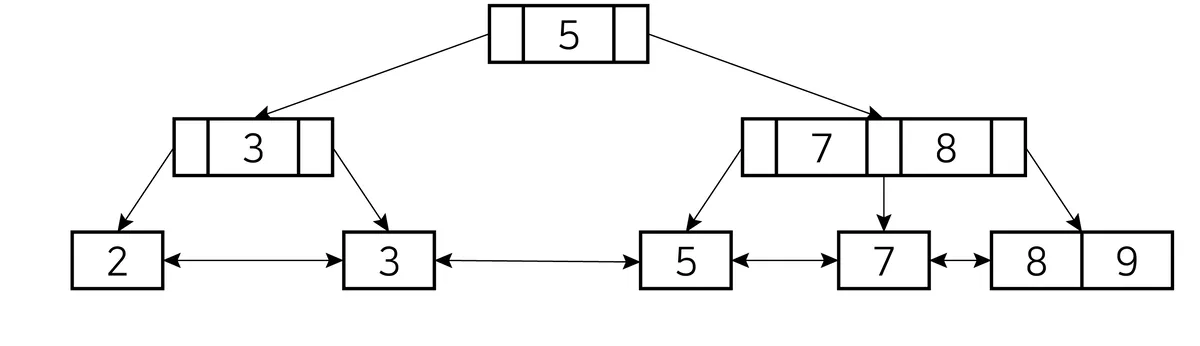
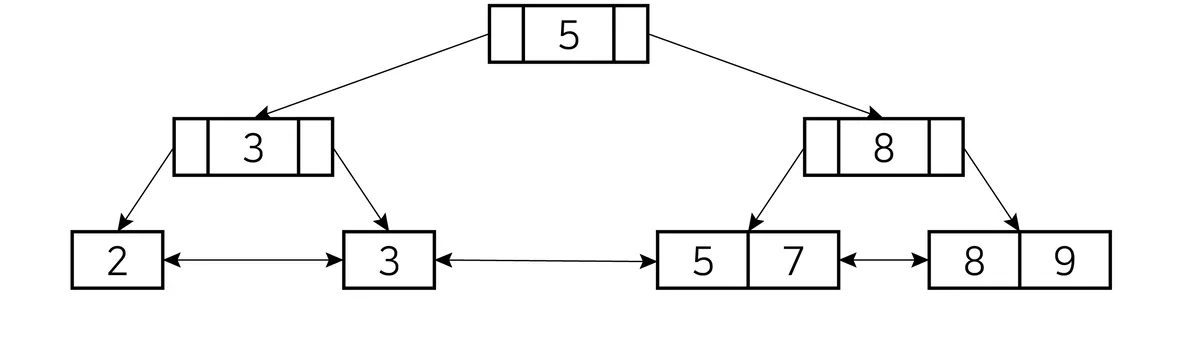
키값 2, 3, 5를 차례대로 삽입하여 다음과 같은 B+-트리가 생성되었다. 이후 9, 8, 7을 차례대로 삽입한 후 B+-트리로 옳은 것은? (단, B+-트리의 차수는 3이다)
- ①
- ②
- ③
- ④
67번
데이터베이스 관리시스템의 로그 레코드 버퍼링(log record buffering)에 대한 설명으로 옳지 않은 것은?
- ①
로그 레코드가 상당 기간 메인 메모리에 있으면 시스템 장애 시 해당 로그 레코드가 손실될 수 있다.
- ②
트랜잭션의 원자성을 보장하기 위한 회복 기법으로 로그 우선 기록 규약(write-ahead log protocol)을 지원해야 한다.
- ③
시스템 장애 시 복구를 위해 변경 사항을 즉시 디스크에 기록하며, 이는 시스템의 성능을 최적화하는 데 중요한 역할을 한다.
- ④
트랜잭션이 수행되는 동안 발생하는 변경 사항을 일시적으로 메모리 버퍼에 저장하여, 디스크 출력 횟수를 줄이고 시스템 성능을 향상시킨다.
68번
다음에서 설명하는 테이블에서 모든 회원의 이름과 추천인의 이름을 함께 출력하기 위한 SQL문은? (단, 추천인이 없는 경우 추천인의 이름은 NULL 값으로 출력한다)
- ①
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e LEFT OUTER JOIN 회원 s
ON e.추천인아이디 = s.아이디;
- ②
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e, 회원 s
WHERE e.추천인아이디 = s.아이디;
- ③
SELECT 이름, 추천인이름
FROM 회원 e
WHERE EXISTS
(SELECT 이름 AS 추천인이름 FROM 회원 WHERE e.아이디 = 추천인아이디);
- ④
SELECT e.이름, s.이름 AS 추천인이름
FROM 회원 e, 회원 s
WHERE e.추천인아이디 = s.아이디
AND e.추천인아이디 IS NOT NULL;
69번
분산 데이터베이스 시스템에 대한 설명으로 옳은 것만을 모두 고르면?
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄹ
- ③
ㄴ, ㄷ
- ④
ㄷ, ㄹ
70번
(가) ~ (다)의 빅데이터 분석 기법과 A ~ C의 설명이 바르게 연결된 것은?
(가) 군집 분석 | (나) 분류 분석 | (다) 연관 분석 |
(가) (나) (다)
- ①ABC
- ②BAC
- ③BCA
- ④CAB
71번
다음은 항공권 예약 시스템에서 좌석 예매와 결제 처리를 수행하는 트랜잭션 코드이다. 트랜잭션 수행 중 UPDATE 문이 끝난 뒤 (가) 지점에서 장애가 발생하여 이 트랜잭션이 성공적으로 완료되지 못할 때, 이 상황과 관련된 트랜잭션의 특성과 해결 방법으로 옳은 것은? (단, 동시에 수행 중인 다른 트랜잭션은 없다)
- ①
원자성(Atomicity)을 보장하기 위한 ROLLBACK 처리
- ②
지속성(Durability)을 보장하기 위한 TRIGGER 처리
- ③
고립성(Isolation)을 보장하기 위한 SAVEPOINT 처리
- ④
일관성(Consistency)을 보장하기 위한 START TRANSACTION 처리
72번
데이터베이스의 시스템 카탈로그에 저장되는 데이터로 옳지 않은 것은?
- ①
속성의 데이터 타입
- ②
테이블에 저장된 레코드 값
- ③
데이터에 대한 다양한 제약 조건
- ④
테이블 이름, 인덱스(index) 이름, 뷰(view) 이름
73번
트랜잭션 , , 에서 데이터 x, y, z에 대한 읽기와 쓰기 작업의 스케쥴이 다음과 같을 때 옳은 것만을 모두 고르면?
시간 | |||
read(y) | |||
read(z) | |||
read(x) | |||
write(x) | |||
read(z) | |||
write(y) | |||
read(y) | |||
write(y) | |||
write(z) | |||
read(x) |
- ①
ㄱ, ㄴ
- ②
ㄱ, ㄷ
- ③
ㄴ, ㄷ
- ④
ㄱ, ㄴ, ㄷ
74번
직원(사번, 이름, 부서, 전화번호, 월급, 고용일) 테이블에 대한 유효한 표준 SQL문으로 옳지 않은 것은? (단, 밑줄 속성은 기본키이다)
- ①
SELECT 사번, 월급
FROM 직원
ORDER BY 월급;
- ②
SELECT *
FROM 직원
WHERE 이름 LIKE '김%';
- ③
SELECT AVG(월급)
FROM 직원
WHERE 부서 = '인사팀';
- ④
SELECT SUM(부서, 월급)
FROM 직원
GROUP BY 부서;
75번
DBMS의 3단계 스키마 구조에서 사상(mapping)과 데이터 독립성에 대한 설명으로 옳지 않은 것은?
- ①
외부/개념 사상은 외부 스키마의 데이터가 개념 스키마의 어떤 부분에 해당하는지 대응 관계를 정의한 것이다.
- ②
개념/내부 사상은 개념 스키마의 데이터가 내부 스키마를 통해 물리적 장치에 저장되는 대응 관계를 정의한 것이다.
- ③
내부 스키마가 변경되어도 개념/내부 사상을 수정하면 개념 스키마가 영향을 받지 않는다.
- ④
개념 스키마가 변경되어도 외부 스키마에 영향이 없는 성질을 물리적 데이터 독립성이라 한다.
76번
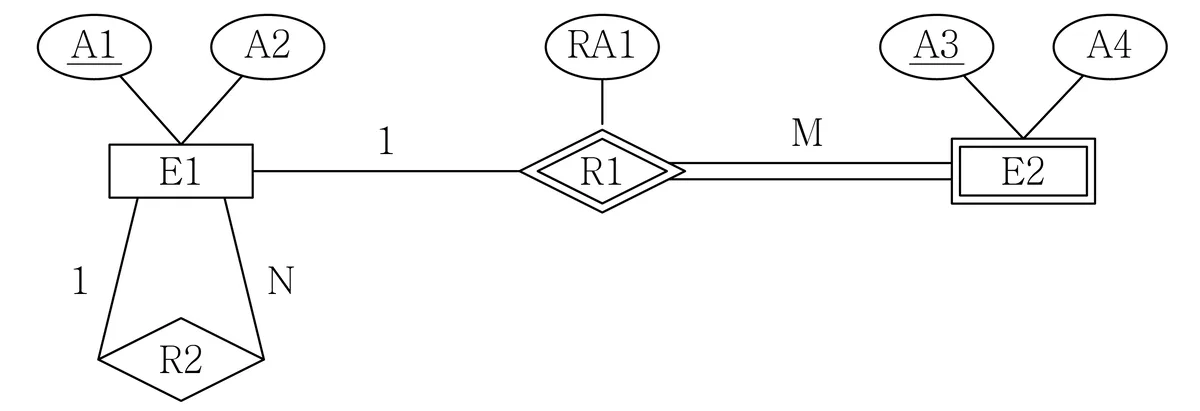
다음 개체-관계 다이어그램(E-R diagram)을 관계형 데이터베이스 스키마로 변환하면? (단, 밑줄 속성은 기본키이고, RA2와 ‘E2’ 릴레이션의 A1은 ‘E1’ 릴레이션의 A1을 참조하는 외래키이다)
- ①
E1(A1, A2, RA2)
E2(A3, A4, RA1)
- ②
E1(A1, A2, RA1, RA2)
E2(A3, A4)
- ③
E1(A1, A2, RA1, RA2)
E2(A1, A3, A4)
- ④
E1(A1, A2, RA2)
E2(A1, A3, A4, RA1)
77번
‘선수’ 테이블에서 검색 결과가 다음과 같이 생성되는 SQL문의 (가)에 들어갈 내용은?
선수 | ||||
선수번호 | 이름 | 포지션 | 점수 | 팀번호 |
2123 | 장영실 | CF | 30 | 2 |
3321 | 이순신 | RB | 12 | 1 |
2276 | 정약용 | LW | 6 | 1 |
1925 | 허준 | RW | 24 | 1 |
9842 | 김유신 | GK | 10 | 2 |
검색 결과 | ||||
팀번호 | 합계점수 | 최대점수 | ||
2 | 40 | 30 |
- ①
GROUP BY 팀번호;
- ②
GROUP BY 선수번호;
- ③
GROUP BY 팀번호 HAVING AVG(점수) >= 15;
- ④
GROUP BY 팀번호 HAVING MAX(점수) >= 20;
78번
인덱스에 대한 설명으로 옳은 것은?
- ①
SQL문에서 조인 연산에 자주 사용되는 속성은 인덱스로 적합하다.
- ②
클러스터링(clustering) 인덱스는 검색 효율을 위해 테이블당 2개 이상 활용된다.
- ③
밀집(dense) 인덱스는 데이터 파일의 레코드 그룹에 대해 생성되는 하나의 엔트리이다.
- ④
인덱스를 구성하기 위한 자료구조로는 이진 탐색 트리(binary search tree)가 가장 많이 활용된다.
79번
다음 ‘부품상태’ 테이블에서 도출할 수 있는 함수 종속을 화살표(→)로 표현할 때 옳은 것만을 표현한 것은? (단, 밑줄 속성은 기본키이며, 아래 투플을 기준으로 판단한다)
부품상태 | ||||
상태번호 | 상태 | 재고위치 | 부품번호 | 수량 |
S1 | 20 | 서울 | P1 | 300 |
S1 | 20 | 서울 | P2 | 200 |
S1 | 20 | 서울 | P3 | 400 |
S1 | 20 | 서울 | P4 | 200 |
S1 | 20 | 서울 | P5 | 100 |
S1 | 20 | 서울 | P6 | 100 |
S2 | 10 | 부산 | P1 | 300 |
S2 | 10 | 부산 | P2 | 400 |
S3 | 10 | 부산 | P2 | 200 |
S4 | 20 | 서울 | P2 | 200 |
S4 | 20 | 서울 | P4 | 300 |
S4 | 20 | 서울 | P5 | 400 |
- ①
{상태번호} → {재고위치} {부품번호, 수량} → {상태}
- ②
{부품번호} → {상태번호} {상태번호, 부품번호} → {상태}
- ③
{부품번호} → {수량} {상태번호, 상태} → {부품번호}
- ④
{상태번호} → {상태, 재고위치} {상태번호, 부품번호} → {수량}
80번
다음 R과 S 테이블에 대해, 주어진 ‘관계대수’와 동일한 투플 결과를 출력하는 ‘SQL 문’은? (단, 밑줄로 표기된 속성은 기본키를 의미한다)
R | S | |||||
A | B | C | A | |||
a1 | 5 | c1 | a1 | |||
a2 | 10 | c2 | a1 | |||
a3 | 15 | c3 | a2 | |||
a4 | 20 | c4 | a3 |
- ①
관계대수: σ(B < 10)(R)
 R.A=S.A S
SQL 문: SELECT DISTINCT R.A, R.B, S.C, S.A
FROM R INNER JOIN S
WHERE R.B < 10;
- ②
관계대수: R
N SSQL 문: SELECT DISTINCT R.A, R.B, S.C
FROM R, S
WHERE R.A IN (SELECT S.A FROM S);
- ③
관계대수: R
 S
SQL 문: SELECT DISTINCT R.A, R.B
FROM R, S
WHERE R.A = S.A;
- ④
관계대수: R
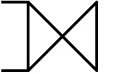 S
SQL 문: SELECT DISTINCT R.A, R.B, S.C
FROM R, S
WHERE R.A = S.A;
제출하면 채점되고 결과 카드가 만들어집니다. 제출 전에는 정답을 볼 수 없습니다.